2019년 9월 16일 월요일

화성으로 가는 탑승권

NASA에서 2020년 발사 예정인 화성탐사선(MARS2020)을 기념하여 탑승권을 발급하는 이벤트를 벌이고 있다. 마감은 9월 말까지이다. 탑승권을 받은 사람들의 이름은 칩에 담아 우주선에 실린다고 한다. 사람을 보낼 수는 없는 노릇이니.

나는 9,342,924번째 탑승자이다. 탑승권의 원본 사이트는 여기에 있다.


이 이벤트에 관한 소식은 대덕넷에서 접했다. 재치있고 낭만적인 이벤트가 아닌가. 여기에 접속하여 이름과 국가명, 우편번호, 그리고 이메일 주소만 넣으면 된다.

국내만 '20만명'..."이번달까지 화성에 이름 보내세요"

잠시 상상의 나래를 펼쳐보자. 인적사항을 담은 화성 탐사선이 지구를 출발하여 가는 도중에(혹은 화성에 도착하여) 외계인에게 납치가 된다. 외계인은 탐사선이 보유한 모든 정보를 해독하여 지구인 백만명의 이메일 주소를 알아내고(그렇다, 외계인에 의한 해킹이다!) 악성코드를 심은 이메일 메시지를 뿌린다. 이메일을 열어본 사람은 갑자기 정신상태가 이상해지면서 외계인들에게 조종당한다... 어, 잘만 다듬으면 공상과학영화 시나리오 한 편이 나오겠는걸.

실제로 우주선에 실리는 정보는 이름 정도일 것으로 생각된다. 덜렁 영문으로 쓰인 이름만 가지고 엉뚱한 일을 하기는 어려울 것이다.

이러한 이벤트를 우리나라에서 할 수 있을까? 아마도 개인정보보호법에 의거하여 동의서를 받아야만 될 것이다. 우리나라에서 이메일 주소는 개인정보로 취급하고 있다. 다른 정보를 포함하면 개인을 식별할 수 있다고 판단하기 때문이다. 따라서 화성 탐사선에 내 이름을 실어보내자는 낭만적인 이벤트를 우리나라에서는 하기 어렵다. 자유로운 상상력을 틀 안에 가두는 규제가 우리에게는 너무 많다.

2021년 1월 26일 업데이트

화성 탐사선 'Perseverance'가 미국 현지시간으로 2021년 1월 18일 화성 표면에 무사히 착륙하였다. 꼭 2년 전에 이름을 올린 탑승권이 이 탐사선에 실려 있다는 것을 까맣게 잊고 있었다.

이런 명판에 마이크로칩 1천만명이 넘는 지구인의 이름이 새겨져 있다. 나도 그 중의 하나다. 출처: 한겨레신문


2019년 9월 12일 목요일

6LQ8 PP 앰프의 소소한 개선 - low-pass filter를 달기

6LQ8 진공관은 원래 오디오용 주파수의 증폭에 쓰기 위해서 개발된 것이 아니다. 가뜩이나 증폭률이 높은 진공관이라서 오디오용 앰프를 만들면 발진(oscillation)을 일으키기 쉽다고 한다. 발진이라고 해서 반드시 '삐~'하는 소리가 난다는 뜻은 아니다. 저항이나 캐패시터와 같은 수동 부품을 적당히 덧입혀서 발진을 잡는 방법이 잘 알려져 있지만, 어차피 오디오용 관이 아닌 것으로 진지하게 음악 감상을 하기 위한 앰프를 만드는 것을 싫어하는 사람들도 있다. 이것은 선택과 취향의 문제이다.

다음은 제이앨범에서 권장하는 6LQ8 푸시풀 앰프용의 '검증된' 발진 대책이다. 초단(전압증폭단)의 플레이트에 연결된 부하 저항(R5)에 저항+캐패시터로 이루어진 바이패스 회로를 붙이는 것이다. 이어지는 회로에는 낮은 주파수를 보내는 셈이니 일종의 low-pass filter라고 불러도 무방하겠다. 높은 주파수를 차단하는 역효과가 없지는 않겠으나 가청 주파수 영역에서는 상관이 없을 것이다. 이렇게까지 하여 오디오용이 아닌 진공관을 사용하여 오디오 앰프를 만드는 것에 대하여 부정적인 시각을 가진 사람이 없지는 않다. 이런 노력을 들일 바에야 아직도 쓸만하게 많이 남아있는 오디오용 진공관을 쓰는 것이 낫다는 의미가 되겠다.


부품을 붙일 자리가 없어서 PCB를 뒤집어서 패턴면에 부품을 납땜하였다. 중간쯤에 보이는 103 메탈필름캐패시터(IC114 링크)가 이번에 새로 붙인 부품이다. 한쪽 리드선에는 1K 저항을 직렬로 연결하였다.


신호를 연결하지 않고 볼륨 노브를 최대로 돌렸을 때 들리는 잡음은 확실이 줄어들었다. 그러면 가청 주파수의 높은 쪽 대역에서 손해를 보았을까? 파형 발생기와 오실로스코프로 측정을 하지 않으면 알기가 어렵다. 뿐만 아니라 바이패스 회로를 연결하기 전후의 상황을 비교해야 차이를 발견할 수 있을 것이다. 단지 음악 신호를 연결해서는 고음 신호를 깎아먹어서 음질이 더 나빠졌는지를 알 수가 없었다. 약간 둔탁해진 것인가? '그럴 것'이라는 선입견이 감각을 왜곡하는지도 모르겠다. 만약 측정을 통해서 가청 주파수 대에서는 변화가 없다는 것이 입증되면, 아마도 그 순간부터는 갑지가 소리가 좋게 느껴질지도 모르는 것이다. 마치 플라시보 효과처럼 말이다.

2019년 9월 13일 업데이트

필터를 붙인 이후 소리가 어딘가 모르게 둔탁해졌다는 느낌이 들기 시작했다. 고음을 너무 깎아버려서 그런 것이 아닐까. 앰프를 다시 작업대에 올리고 한쪽 채널만 필터를 제거하고 신호를 연결하여 좌우를 비교하니 너무나 확연한 차이가 났다. 이런 식의 잡음 제거 효과라면 없느니만 못하다는 생각에 양 채널에서 필터를 전부 제거하였다. 정상적인 negative feedback 회로 이외의 것을 달아서 잡음 등을 제거하려는 시도는 상당히 조심해야 되겠다.

2019년 9월 9일 월요일

Ubuntu에서 hear string이 작동하지 않는 이유

CentOS(bash)에서는 잘 돌던 스크립트가 Ubuntu에서는 에러가 발생하였다. 왜 그런 것일까?

$ cat test
echo $(cut -d_ -f1 <<< "123_456")
$ sh test
test: 1: test: Syntax error: redirection unexpected
$ bash test
123

이유를 알아보자. 우분투의 기본 shell은 bash가 아니고 dash라고 한다. 이 환경에서는 here document 또는 here string이 잘 작동하지 않는다고 하였다.

[Ubuntu/Linux] #!/bin/sh에 대한 간단한 이야기

따라서 위에서 소개한 test 스크립트의 shebang line에 #!/bin/sh를 삽입해 봐야 소용이 없다. 우분투에서는 /bin/sh가 dash를 가리키기 때문이다. 이 한줄짜리 스크립트를 제대로 돌리려면 첫줄에 #!/bin/bash를 삽입해야 한다. 그러나 실행할 때 sh test라고 하면 도루묵이다. 실행 권한을 주어서 ./test라고 실행해야 한다. 당연한 이야기이다.


AWK를 이용한 fasta file splitter

여러 염기서열로 이루어진 multi-fasta file을 쪼개에서 각 서열이 하나씩의 파일에 담기게 하는 작업은 매우 흔히 벌어지는 일이다. 나도 10줄 조금 넘는 Perl 스크립트를 만들어서 fasta file을 분리하는데 종종 쓰고는 한다.

awk를 쓰면 달랑 코드 한 줄로 fasta file splitter를 만들 수 있지 않을까? 구글에서 검색을 해 보니 이에 대한 많은 질문과 답이 있었다. 이를 참조하여 다음과 같은 awk 명령어를 만들어 보았다.  awk의 명령에 내에서 shell과 유사하게 파일로 직접 인쇄결과를 리다이렉션할 수 있다는 것을 몰랐다. 파일핸들을 정의하고 여닫는 일을 하지 않아도 되니 Perl보다 더 간단한 코드가 되었다. 아무런 실수가 없을 것으로...믿는다.

$ awk '/^>/{s=$0; sub(/^>/, "", $1); F=$1".fa"; print s > F; next}{print >> F}' input.fasta

awk를 쓰면서 종종 혼동하는 것은 sub() 함수가 치환된 문자열을 반환하지는 않는다는 것이다. 즉 var = sub(regexp, replacement, target) 형태로 사용하면 안된다.

코드를 간단히 분석해 보자. 서열 ID(>seq_id)가 있는 줄을 만나면, 첫번째 컬럼($0)에서 '>'를 제거한 뒤 .fa를 붙여서 출력할 파일의 이름을 만들어 변수 F에 저장한다. 그런데 sub() 함수에서 직접 $1을 건드리게 되므로, 나중에 원본 라인을 그대로 출력하기 위하여 명령어 맨 처음에 s라는 변수에 미리 서열 ID 라인을 저장해 놓는 꼼수(s=$0)를 사용했다. 그 다음에 유의할 것은 '/조건/{조건에 맞는 줄에 대하여; next} {조건에 맞지 않는 나머지 줄에 대해 실행}' 명령을 이해하는 것이다. 여기에서 next가 매우 중요한 역할을 담당한다. 이에 대해서는 예전의 포스팅에서 두번 정도 다룬 것 같다.

이 방법을 이용하면 SRR2162225(Gopalakrishnan et al., 2018)의 fastq 파일을 각 샘플별로 쪼갤 수도 있다. 이 fastq file은 다음과 같은 형식의 sequence ID를 갖고 있다. 내용상으로는 이미 demultiplexing이 된 것에 해당하지만 하나의 fastq 파일에 전부 수록되어 있다.

@ERR2162225.10 Wargo.109865_330283 length=253

두번째 필드를 추출하여 빨간색으로 표시된 것을 파일 이름으로 하는 fastq 파일을 만들어 보자. 현 디렉토리에 43개의 fastq 파일이 생겼다.

$ awk '/^@ERR2162225/{s=$0; sub(/_.+$/, "", $2); F=$2".fastq"; print s > F; next}{print >> F}' ERR2162225.fastq
$ ls
ERR2162225.fastq    Wargo.121296.fastq  Wargo.122637.fastq  Wargo.124418.fastq  Wargo.130511.fastq  Wargo.132266.fastq
Wargo.109865.fastq  Wargo.121409.fastq  Wargo.122639.fastq  Wargo.124419.fastq  Wargo.130801.fastq  Wargo.132268.fastq
Wargo.115690.fastq  Wargo.121585.fastq  Wargo.122724.fastq  Wargo.124421.fastq  Wargo.131051.fastq  Wargo.132538.fastq
Wargo.116774.fastq  Wargo.121891.fastq  Wargo.123009.fastq  Wargo.126747.fastq  Wargo.131300.fastq  Wargo.133270.fastq
Wargo.117349.fastq  Wargo.121892.fastq  Wargo.123197.fastq  Wargo.126802.fastq  Wargo.131302.fastq
Wargo.118369.fastq  Wargo.122114.fastq  Wargo.123305.fastq  Wargo.127261.fastq  Wargo.131512.fastq
Wargo.118370.fastq  Wargo.122410.fastq  Wargo.123704.fastq  Wargo.127262.fastq  Wargo.131541.fastq
Wargo.120662.fastq  Wargo.122412.fastq  Wargo.123986.fastq  Wargo.130510.fastq  Wargo.132265.fastq

다른 사례를 하나 더 들어보자. 다음은 vsearch --derep_fulllength로 dereplication을 거친 염기서열 파일의 일부를 보이고 있다.

>Mock.1;size=492
TACGTAGGTGGCAAGCGTTATCCGGAATTATTGGGCGTAAAGCGCGCGTAGGCGGTTTTTTAAGTCTGATGTGAAAGCCCACGGCTCAACCGTGGAGGGTCATTGGAAACTGGAAAACTTGAGTGCAGAAGAGGA
AAGTGGAATTCCATGTGTAGCGGTGAAATGCGCAGAGATATGGAGGAACACCAGTGGCGAAGGCGACTTTCTGGTCTGTAACTGACGCTGATGTGCGAAAGCGTGGGGATCAAACAGG
>Mock.2;size=345
TACAGAGGGTGCGAGCGTTAATCGGATTTACTGGGCGTAAAGCGTGCGTAGGCGGCTTATTAAGTCGGATGTGAAATCCCCGAGCTTAACTTGGGAATTGCATTCGATACTGGTGAGCTAGAGTATGGGAGAGGA
TGGTAGAATTCCAGGTGTAGCGGTGAAATGCGTAGAGATCTGGAGGAATACCGATGGCGAAGGCAGCCATCTGGCCTAATACTGACGCTGAGGTACGAAAGCATGGGGAGCAAACAGG

size=뒤에 나오는 모든 숫자를 더하면 dereplication 작업 전 FASTA file에 포함된 전체 서열의 수를 알 수 있다. 오늘 익힌 awk의 sub() 함수를 이용하면 간단하다.

$ awk 'BEGIN{s=0}/^>/{sub(/^>.*size=/, "", $0);s+=$0}END{print s}' input.fasta
4268

별로 설명할 필요도 없다. 서열 ID 라인에 description이 있다면 $0을 $1로 바꾸면 그만이다. 아니, 처음부터 code를 $1로 고쳐 놓으면 description이 존재하는지 여부에 상관없이 잘 돌아간다.

Bioinformatics on-liner

One-liner 애호가를 위하여 Stephen Turner의 GitHub 사이트를 소개한다(링크).

2019년 9월 6일 금요일

Robert Edgar, 멋진 사업가? 과학자? 프로그래머? 소프트웨어 엔지니어?

16S rRNA amplicon sequencing에 기반하는 메타게놈 분석 방법(주로 QIIME)을 요즘 집중적으로 공부하는 과정에서 QIIME documentation 웹사이트 말고도 하루에도 몇번씩 방문하는 곳이 있다. 바로 http://drive.com/이다. 이 사이트의 운영자는 Robert Edgar이다.

Robert Edgar(출처)
1982년 런던 대학에서 입자물리학으로 박사학위를 받았고 IT 분야의 비즈니스 경험도 많지만 생명정보학 분야에서는 MUSCLE이나 USEARCH와 같은 유명한 프로그램의 개발자로 잘 알려져 있다. 그는 2001년부터 스스로를 특별한 소속 없이 일하는 독립과학자(independent scientist)로 칭하면서 주로 전산생물학과 생물정보학 분야에서 많은 사람들에게 도움을 주고 있다.

그가 어떤 사람인지는 개인적으로 전혀 모르지만, 대학이나 기업에 몸담고 있지 않으면서 이렇게 프리랜서와 같이 일하면서 꾸준히 프로그램을 개발하여 배포하고 논문을 발표한다는 것이 대단하다고 느껴진다. 그의 홈페이지를 방문하면 최근 발표한 논문의 목록이 보이는데 저자는 전부 혼자다! 1975년에 대학에 입학하여 지금 교수로 재직한 전형적인 한국인 과학자가 있다고 하자. 이제 정년 퇴임이 얼마 남지 않은 나이일 것이다. 과연 동료나 후배(선배는 전부 은퇴했을 것이니), 또는 대학원생의 참여 없이 논문에 저자로 이름을 올릴 수가 있을까?

R. Edgar의 USEARCH는 64비트 버전을 이용하려면 돈을 주고 구입해야 한다. 하지만 32비트 버전은 무료이다. 무료라고 해서 소스 코드가 공개되어 있지는 않다. 프로그램의 기본 알고리즘은 논문이나 drive5.com 웹사이트에 소개가 되어 있으나 소스 코드는 비공개이니 사람들이 불만을 느낄 수도 있다. 그런 취지에서 VSEARCH가 3년 전에 나왔고, 웹을 검색해 보니 아주 훌륭한 16S rRNA 서열 분석용 파이프라인이 공개된 것도 발견할 수 있었다(링크). 이것 역시 공부하기에 아주 좋은 자료이다.

VSEARCH의 논문 초록에서는 USEARCH를 살짝 '디스'하고 있다. 인용해 볼까?

 [VSEARCH] is designed as an alternative to the widely used USEARCH tool () for which the source code is not publicly available, algorithm details are only rudimentarily described, and only a memory-confined 32-bit version is freely available for academic use.

그래도 USEARCH는 학계에서 충분히 제 역할을 하고 있지 않은가?

나는 생명정보학을 체계적으로 배우질 않아서 이 학문의 역사에 대해서는 매우 단편적인 지식밖에 갖고 있지 못하다. 나의 짧은 경험으로 존경하고 싶은 생명정보학자, 또는 이 분야의 소프트웨어 개발자는 이런 분들이 있다. 이 목록은 절대로 생명정보학 명예의 전당 같은 것도 아니고, 이 분야를 모두 망라한 것도 아니다. 누구나 흔히 생각할 수 있는 David Lipman 같은 사람은 뺐다. 내가 현재 하고 있는 일에 대해서 직접적인 영향을 미친 사람들이다.

Margaret Oakley Dayhoff
Phil Green
David Gordon(CONSED의 개발자)
Jim Kent(흠, 정작 나는 BLAT를 거의 쓰지 않는데)
Sean Eddy
Lincoln Stein(BioPerl하면 떠오르는 사람)
Art Delcher(MUMmer 개발자)
Ewan Birney
Eugene Myers 등.

여기에 R. Edgar도 넣어줘야 되겠다.

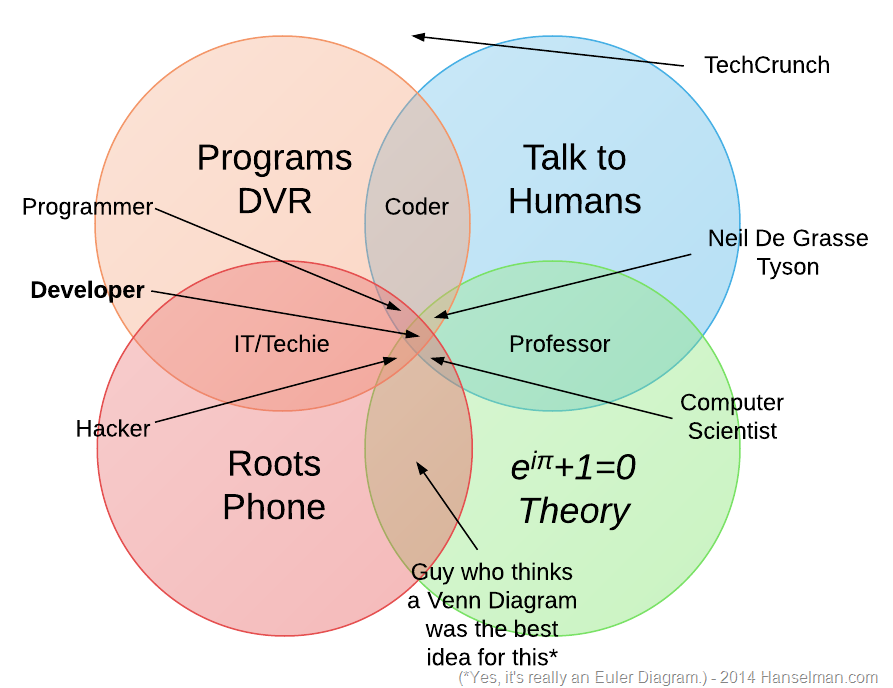
개발자, 프로그래머, 컴퓨터 사이언티스트, 소프트웨어 엔지니어의 차이는?

다음의 글을 참조하라.


그리고 이 글에서 인용한 원문 및 그림(링크).

출처: Scott Hasnselman

2019년 9월 4일 수요일

QIIME 1을 위한 sequence data 준비 과정 - demultiplexed paried-end fastq의 복잡한 사정

약 일주일에 걸쳐서 QIIME 1을 집중적으로 공부하면서 느낀 것은 sequencing data 파일로부터 seqs.fna를 만드는 과정이 전체 수고의 1/3 정도는 되는 것 같다는 점이다. 더군다나 아직 실제 16S rRNA 데이터를 생산한 경험이 없어서 SRA에서 자료를 받아서 연습을 하니 그 과정이 더욱 어렵게 느껴졌다. 왜냐하면 서열 ID 라인의 형식이 실제 MiSeq에서 생산된 직후의 fastq 파일 모습을 그대로 따르고 있지 않으며, 메타데이터 역시 제대로 마련되지 않았기 때문이다. 하지만 그 덕분에 SRA-Toolkit의 prefetch와 fastq-dump의 기능을 제대로 이해하게 되었으며, NCBI 웹사이트에서 run accession의 목록 파일을 손쉽게 입수하는 방법을 알게 되는 성과는 있었다.

QIIME 1에서는  Roche/454 pyrosequencing data 또는 barcode read가 별도로 주어지는 Illumina multiplexed single end data가 가장 다루기 편한 것 같다. 바코드 서열과 샘플의 연결 관계는 metadata mapping file(map.tsv)에서 주어진다. 이는 간단히 mapping file이라고도 부른다. 그러나 2019년 9월 초순 현재 국내 시퀀싱 서비스 업체에서는 16S rRNA 시퀀싱 데이터를 이러한 형태로 고객에게 전해주는 것 같지는 않다. 결과 파일인 seqs.fna에서 각 염기서열의 ID는 (샘플이름)_(일련번호)의 형식을 갖는다.


$ split_libraries_fastq.py -o slout/ -i forward_reads.fastq.gz -b barcodes.fastq.gz -m map.tsv

Paired end read라면 join_paired_ends.py 스크립트로 연결한 뒤 추가적으로 바코드 정보를 업데이트해야 하므로 살짝 작업이 번거로워진다. 바코드 업데이트가 필요한 이유는 모든 read pair가 전부 성공적으로 연결되는 것은 아니기 때문이다. 지난주에 천랩에 고객에게 제공되는 16S rRNA amplicon sequencing data의 타입에 대해 문의하니 MiSeq 한 레인 단위의 복수의 샘플을 받아서 시퀀싱을 한 다음 전부 demultiplexing을 해서 고객에게 보내준다고 하였다. 이러한 데이터는 QIIME 1에서 오히려 다루기가 더 불편하다. QIIME 2의 문법으로 말하자면 이는 Casava 1.8 paired-end demultiplexed fastq 파일에 해당한다.

Demultiplexed paired end 데이터를 이용한 QIIME 분석의 좋은 사례는 2016년도 EDAMAME 워크샵(위키 및 GitHub)에서 제공한 교육 자료에 있다. 이 자료를 만든 사람들 중에는 한국 사람이 틀림없는 이름(Sang-Hoon Lee)이 있어 반갑게 느껴지기도 했다. 여기에서 샘플 파일을 다운로드하여 압축을 풀면 V4 region을 증폭하여 MiSeq으로 양쪽에서 150 bp를 읽은 파일 54쌍이 나온다(C01D01F_sub.fastq, C01D01R_sub.fastq...). QIIME 1 script인 join_paired_ends.py는 한번에 한 쌍의 파일만 처리하므로, 파일이름 베이스를 수록한 list.txt를 만들어서 각 파일에 대하여 순차적으로 join_paired_ends.py을 실행한 다음 연결이 된 sequence만 가져다가 사용하는 스크립트인  Merged_Reads_Script.sh를 사용하는 방법을 소개하였다. 이 스크립트를 실행하면 몇 단계를 거쳐서 Merged_Reads라는 디렉토리에 52개의 fasta 파일이 만들어진다. 다음 단계에서는 add_qiime_labels.py를 사용하여 combined_seqs.fna라는 최종 결과물을 만든다. add_qiime_labels.py는 mapping file을 필요로 한다. 원래 이 파일에는 BarcodeSequence 컬럼이 있어서 각 read에 부가된 바코드로부터 sequence를 구분하는 중요한 역할을 하지만, 이 경우에는 이미 demultiplexing이 되어 있어서 이는 중요하지 않다. 단 InputFileName 컬럼에 있는 fasta file 이름이 각 sequence 파일을 분류하는 기준이 된다. 이 경우에는 필수 컬럼인 BarcodeSequence 컬럼은 공백으로 비워져 있어도 된다.

나는 Merged_Reads_Script.sh를 응용한 merge_paired_fasta.sh 스크립트를 만들어 보았다. 별도의 list.txt 파일이 없이도 쌍을 이룬 fastq 파일이 있으면 작동하며, 최종 결과물로서 fasta + fastq를 같이 만들어내는 것이다. Merged_Reads_Script.sh에서는 merged fastq를 지우도록 만들어 놓았다.

combined_seqs.fna 또는 seqs.fna 파일 내에서 각 서열의 번호는 새로운 샘플에 대해서 무조건 0또는 1부터 시작한다고 생각했는데 그건 착각이었다. 위에서 설명한 방법으로 만들어진 combined_seqs.fna의 서열 일련번호는 _1에서 시작하여(_0으로 시작하게 만들 수도 있음; 전산인들이 좋아하는 방법) 샘플이 바뀌어도 계속 증가한다. 사실 각 read가 구별만 되면 충분한 것이다. 만약 샘플마다 1번부터 시작하게 만들면 일련번호만으로 sequence를 구별하기 어려워지므로 이는 당연한 것이다.

Demultiplexed paird end data를 다루는 방법은 이상의 것이 가장 권장할 만한 것으로 보인다. 이것 외에도 오늘 오후를 종일 투자하여 QIIME 스크립트 자체에 충실한 방법을 만들어내기는 했는데 하도 신경쓸 것이 많아서 과연 이것을 블로그에 기록하는 것이 현명한 일인지 아닌지 잘 판단이 서지 않는다. 간단히 소개하자면 여기에서는 multiple_join_paired_ends.py와 multiple_split_libraries.py를 사용한다. 하나의 디렉토리 안에 샘플별로 이름이 붙은 read pair가 전부 들어있는 경우(아마 대부분의 경우일 것임)와, 샘플별로 구분된 디렉토리 안에 한 쌍씩의 파일이 들어있고 이것 전체가 하나의 인풋 디렉토리에 들어있는 경우에 따라서 옵션이 약간 달라진다. 후자의 경우라면 fwd 및 rev read fastq file이 같은 이름을 갖고 있을 수도 있다. 샘플별로 이름이 붙은 디렉토리에 들어있으니 당장은 문제가 되지 않는다.

EDAMAME 데이터를 예로 들어서 설명해 본다. 54쌍의 read는 전부 샘플 이름을 기준으로 이름이 지어졌으니 하나의 인풋 디렉토리(예: Fastq)에 넣어서 작업을 해도 문제가 되지 않는다. --include_input_dir_path, --include_input_dir_path --remove_filepath_in_name 옵션을 주고 실행한 다음 결과 디렉토리가 어떻게 다르게 만들어지는지 한번 확인해 보라. --remove_filepath_in_name는 단독으로 쓰이지 못하고 항상 --include_input_dir_path와 같이 쓰여야 한다.

$ multiple_join_paired_ends.py -i Fastq --read1_indicator F_sub --read2_indicator R_sub -o output_folder
$ ls output_folder
C01D01F_sub  C01D02F_sub  C01D03F_sub  C02D01F_sub  C02D02F_sub  log_20190904164417.txt
$ ls output_folder/C01D01F_sub/
fastqjoin.join.fastq  fastqjoin.un1.fastq  fastqjoin.un2.fastq

각 샘플에 대하여 결과물에 대한 서브디렉토리가 생겼고 그 하위에 연결(join)된 것과 그렇지 않은 것들에 대한 fastq file이 생겼다. 여기서부터 주의를 해야 한다. 연결되지 않은 파일은 일단 제거를 해야 하고, 결과 디렉토리며에서 _sub는 없애는 것이 여러모로 편하다. 이것은 알아서 해결을 했다고 가정하고, 다음 단계인 multple_split_libraries_fastq.py로 넘어가자.

$ multiple_split_libraries_fastq.py -i output_folder/ -m sampleid_by_file -o final 
$ head -n 1 final/seqs.fna 
>fastqjoin.join.fastq_0 HWI-M03127:41:ACE13:1:2109:11596:14331 1:N:0:GGAGACAAGGGA orig_bc=AAAAAAAAAAAA new_bc=AAAAAAAAAAAA bc_diffs=0

$ multiple_split_libraries_fastq.py -i output_folder/ -m sampleid_by_file -o final2 --include_input_dir_path
$ head -n 1 final2/seqs.fna
>C01D01fastqjoin.join.fastq_0 HWI-M03127:41:ACE13:1:2109:11596:14331 1:N:0:GGAGACAAGGGA orig_bc=AAAAAAAAAAAA new_bc=AAAAAAAAAAAA bc_diffs=0

$ multiple_split_libraries_fastq.py -i output_folder/ -m sampleid_by_file -o final3 --include_input_dir_path --remove_filepath_in_name
$ head -n 1 final3/seqs.fna
>C01D01_0 HWI-M03127:41:ACE13:1:2109:11596:14331 1:N:0:GGAGACAAGGGA orig_bc=AAAAAAAAAAAA new_bc=AAAAAAAAAAAA bc_diffs=0

--include_input_dir_path --remove_filepath_in_name 옵션을 전부 준 세번째 것이 가장 바람직한 서열 ID를 만들어 내었음을 알 수 있다. 이것으로 pick_open_reference_otus.py를 아무런 에러 없이 실행하였다.

split_libraries_fastq.py를 무식하게 실행하여 소기의 목적을 달성할 수도 있다. 다음은 QIIME의 스크립트 설명에 나오는 가장 마지막 예제이다.

$ split_libraries_fastq.py -i lane1_read1.fastq.gz,lane2_read1.fastq.gz --sample_ids my.sample.1,my.sample.2 -o slout_not_multiplexed_q20/ -q 19 --barcode_type 'not-barcoded'

Fastq 형태로 join을 마친 파일을 한 곳에 가져다 놓고 그 이름을 콤마로 연결하여 -i file1,file2,file3...으로, 그리고 순서를 맞춘 샘플 이름을 --sample_ids sample1,sample2,sample3...으로 제공하면 될 것이다. Shell script를 이용하여 이는 어렵지 않게 구현해 보았다. 단, 바코드는 의미가 없으므로 --barcode_type 'not_barcoded' 옵션을 준다. 상당히 번거로왔지만 테스트는 잘 되었다.

마지막으로 가장 무식한 방법을 생각해 보았다. fastq 파일에서 barcode 판독 정보를 뽑아내는 것이다(multiple_extract_barcodes.py). 그 다음에 이들을 concatenation하여 도로 multiplexed fastq로 전환한 후 split_libraries_fastq.py를 실행하는 것. 원본 파일에 가까운 것을 재구성할 수는 있지만 너무 미련한 방법이다. 그리고 이미 demultiplexing이 된 파일을 입수해 보면 바코드 정보가 fastq 파일 내에 남아있지 않은 경우가 많다. 이론적으로는 안 될 이유가 없지만 시도하지는 말자.

2019년 9월 12일 업데이트

나의 위키 사이트(genoglobe.kr/kribb)에 일루미나 16S rRNA 시퀀싱 데이터를 처리하는 방법을 체계적으로 설명한 글을 올렸다.

2019년 9월 3일 화요일

간단한 AWK 활용 팁 - 컬럼 수의 총 합계 구하기 등

QIIME에서 사용하기에 좋은 매우 간단한 awk 활용 예제를 소개해 본다. OTU map file은 similarity에 의해 묶인 서열의 클러스터를 표현한 tab-delimited text file이다. 한 줄은 하나의 클러스터이며 맨 왼쪽은 클러스터의 ID, 나머지 컬럼은 클러스터를 이루는 각 서열의 ID이다.


총 몇 개의 서열이 클러스터를 이루는 것일까? awk가 이를 간단하게 계산해 준다.

$ awk 'BEGIN{s=0}{s+=NF-1}END{print s}' final_otu_map.txt

NF는 awk의 내장 함수로서 컬럼의 수를 의미한다. 첫번째 컬럼은 클러스터 ID므로 NF에서 하나를 뺀 것을 더해나간 뒤(변수 s에 저장), 파일의 모든 라인에 대한 처리가 끝나면 인쇄를 하면 된다.

다음은 조건에 맞는 줄은 편집을 하고, 그렇지 않은 줄은 그대로 출력하는 방법을 알아본다. 작년에 'awk를 이용한 같단한 텍스트 파일 조작(join)'이라는 제목의 글로 그 기본 원리에 대해서 이미 포스팅을 한 적이 있었다. 다음은 Gopalakrishnan의 2018년도 Science 논문에서 다룬 16S rRNA sequencing 결과 중 하나인 ERR2162226의 일부를 표시한 것이다.


엄밀히 말하자면 이 파일은 MiSeq가 생산한 그대로의 파일이 아니다. Wargo.R2d2_45029를 서열 ID로 전환하는 것이 오늘의 목표이다. '/1'은 제거해야 한다.

Awk를 사용하면 다음과 같이 명령행 한 줄로 끝난다.


$ awk '/^@ERR2162226/{printf "%s%s\n", "@", substr($2,1,length($2)-2);next}{print}' ERR2162226.fastq > ERR2162226-mod.fastq

awk '조건{명령A; next}{명령 B}' 텍스트파일

이 명령을 이해하는 것이 핵심이다. 조건에 맞으면 A를 실행한 뒤 next를 통해서 뒷쪽의 {명령B} 블록을 건너뛰고, 조건에 맞지 않으면 곧바로 {명령B}를 실행한다. if..else에 해당하는 문법이 아니다!. 만약 next가 없으면, 조건에 맞는 줄에서 명령A를 실행한 뒤, 그 줄에 대해서 또, 명령 B를 실행하게 된다. 이것을 가지고서 fasta로 전환한 뒤(split_libraries_fastq.py의 -q 19 옵션을 적용하여 quality에 의해 필터링하는 것을 똑같이 구현하려면 쉽지는 않음) pick_otus.py 명령을 실행하여 실습을 진행하면 된다.

awk의 printf 함수와 substr 함수의 용법도 이번에 공부를 해 두면 도움이 될 것이다.