2018년 2월 10일 토요일

칼을 갈다

흔히 '칼을 간다'고 하면 비장하게 복수의 날을 기다리며 준비를 하고 있음을 뜻한다. 오늘 칼과 가위를 갈았다. 은유적인 표현이 아니라 정말로 칼과 가위를 갈았다는 것이다. 집에 있는 숫돌로 일반인 수준에서 대충 간 것이 아니라 전문인에게 맡겨서 날을 세웠다. 이렇게 칼을 갈아본 것은 이번이 처음이다. 아내가 날이 무뎌져서 칼을 쓰기 힘들다고 하면 가끔 집에서 갈아주고는 했는데 이것 역시 기술 없이 아무나 하는 일이 아니라서 결과는 늘 만족스럽지 못하였다.

말 그대로 서슬이 퍼렇다.

카센터에 타이어 공기압을 보충하러 가다가 동네 어귀에 트럭을 몰고 가끔 찾아오는 칼갈이 어르신을 만났다. 전화번호는 010-4408-6440(참고로 여기는 대전임). 칼갈이들은 대부분 이동하면서 일을 하므로 필요한 순간에 만나는 일은 쉽지 않다. 인터넷을 찾아보면 출장 칼갈이도 있다. 단체급식소, 병원, 미용실, 조리사 단체시험을 준비하는 학원 등을 대상으로 한다. '칼갈이'이라고 써 놓으니 마치 이 직업을 비하하는 표현처럼 들리는 듯해서 조심스럽다.  '간호원'이 '간호사'가 되고 '때밀이'가 '목욕관리사' 혹은 '세신사'가 되면 여기에 종사하는 사람들의 지위가 향상되는 것일까? 그러면 '칼갈이'는? 순우리말은 한자어에 비해서 격이 떨어진다는 생각이 바뀌어야 한다고 믿는다.

명절을 앞두고 무뎌진 부엌칼을 갈려는 주부가 많을 것이다. 식칼 두 개와 과도, 그리고 지난번에 어렵게 녹을 제거했던 재단 가위(링크) 두 개까지 들고 나갔다. 식칼 하나의 날을 가는 표준 가격은 3,000원이고 두 개는 5,000원이다. 어르신께서는 쉼없이 맡겨진 칼을 갈고 있었다. 한 시간을 기다려 총 다섯 점의 칼과 가위를 가는 비용은 9,000원. 1만원 지폐를 내고 거스름돈은 받지 않았다.


4차 산업혁명을 맞아 대량 실업이 발생해도 살아남는 직업은 무엇이 있을지 가끔 생각해 본다. 대량의 지식을 이용하여 정확한 판단을 해야 하는 지능적이고 고도한 일은 오히려 인공지능이 더 잘 할 것이다. 그러나 사람의 손으로 직접 할 수밖에 없는 직업은 영원히 살아남을 것이다. 배관공, 전기 설비 기사, 이·미용사 등. 칼갈이도 그러할 것이다.

2018년 2월 8일 목요일

병원 배관에 항생제 내성 세균이 우글우글

오늘 아침에 받은 GenomeWeb 시퀀싱 섹션에 실린 기사이다. mBio에 실린 논문 "Genomic analysis of hospital plumbing reveals diverse reservoir of bacterial plasmids conferring carbapenem resistance(링크)"를 소개한 것이다.


카바페넴은 베타-락탐 계열의 항생제 중 적용 대상균의 스펙트럼이 가장 넓은 항생제이다. 최근 카바페넴내성 장내세균속(carbapenem resistant Enterobacteriaceae, CRE)이 전세계적으로 확산되어 큰 문제가 되고있다. 우리나라에서도 2010년 첫 CRE 감염자가 보고된 이래 전국적으로 확산되는 추세이다. CRE는 주로 병원을 통해서 전파된다. 장기간 입원하면서 면역력이 떨어진 사람에게 지속적으로 항생제를 투여하게 되는데, 이때 카바페넴 내성을 지닌 감염세균은 더욱 창궐할 수 있는 기회를 맞는다. 소위 병원내 감염(nosocomial infection)의 원흉이 되는 것이다.

카바페넴을 무력화시키는 효소인 carbapenemase 중에서 특히 NDM-1(New Delhi metallo-beta-lactamase)가 유명하다. 이 효소의 유전자를 지닌 박테리아가 드디어 superberg라는 이름으로 언론에서 오르내리게 된 것이다. 이게 전부가 아니다. Klebsiella pseumoniae carbapenemase(KPC)도 둘째 가라면 서러운 cabapenemase이다. 이들 효소의 유전자는 수평적 전파를 통해서 장내세균속 및 Acinetobacter baumanii와 같은 프로테로박테리아에게 쉽게 전달되어 내성을 퍼뜨리게 된다. 각 효소 단백질을 암호화하는 유전자를 각각 blaKPC, blaNDM이라 부른다.

오늘 소개하는 이 논문에서는 미국 베데스다 지역의 NIHCC (National Institute of Health Clinical Center) 병원에서 2년간 수집한 미생물 샘플 108종의 유전체 서열 해독을 통해 카바페넴 내성 세균의 존재와 다양성을 밝힌 것이다. 변기, 배관, 외부의 맨홀 등이 샘플 채집 장소였다. 이러한 환경은 carbapenemase를 만드는 미생물에게는 vast, resilient reservoir였던 것이다. 이 병원은 2011년  carbapenemase-positive, carbapenem-resistant Klebsiella pneumoniae outbreak가 일어난 곳이기도 하다. 당시 연구에서는 환자의 감염뿐만 아니라 난간, 송풍구, 싱크 배수구, 입원실 벽 등 다양한 곳에서 내성 세균이 검출되었었다(Science Translational Medicine 논문 링크). 당시에도 whole-genome sequencing이 중요한 연구 기법이었다.

감염된 환자와 주변 환경에서 발견된 미생물 종 다양성과 항생제 감수성 프로필은 달랐지만, 두 집단 간의 plasmid backbone에는 공통점이 있었다. 이는 환경 reservoir에 있는 내성 유전자가 mobile element를 통하여 공유됨을 시사한다.

병을 고치러 입원한 병원에서 오히려 약도 듣지 않는 '슈퍼버그'에 감염되어 더 큰 위험에 처한다면 이 얼마나 모순되는 일인가? 작년 12월에 있었던 이대목동병원 신생아 집단 사망 사건이 떠오른다. 희생된 아기들에게서 발견된 Citrobacter freundii는 내가 알기로는 심각한 내성 감염의 원인세균으로 취급되지는 않는데, 면역력이 약한 신생아에게 혈관 주사 등으로 많은 개체가 감염되었다면 치명적일 수 있었을 것이다. 이 사건의 결론이 어떻게 내려졌는지는 모르겠다. 이것은 내가 보기에는 부주의에 의한 사건이라는 생각이 든다.

인간과 감염성 세균과의 싸움은 군비 경쟁과 같다. 우리가 항생제라는 무기를 들면 세균은 내성을 키워서 맞대응한다. 최소한 현상 유지를 하려 해도 새로운 항생제 개발이 필요하다. 그러나 항생제는 제약회사에게 큰 수익을 가져다주지 못하기 때문에 연구개발에 힘을 쏟지 않게 되고, 이에 따라 1987년 이래 새로운 항생제가 개발되지 못했다. 그러다가 2015년 미국 노스이스턴 대학의 Kim Lewis 연구팀에서 teixobactin이라는 항생물질을 자연계에서 발견하면서 30년만의 항생제 발견이라고 하여 크게 주목을 받았었다(당시 Nature 논문 링크).

세균에 맞서는 무기('항생제')를 계속 개발해는 것이 정답일까? 엘크의 뿔, 공작새의 꽁지처럼 남들보다 조금 더 나은 모습이 생존에 유리하게 작용하다가(배우자 후보의 마음에 잘 들게 되므로) 어느 수준 이상이 되면 오히려 생존에 불리해지듯, 항생제를 무기로 한 전쟁에도 결국은 한계가 있지 않을까?


Usearch 맛보기

소프트웨어 이름을 표기할 때 첫글자만 대문자로 써야 하는지(Usearch), 전체를 대문자로 써야 하는지(USEARCH)를 아직도 잘 모르겠다. 만약 소프트웨어의 이름이 acronym이라면 전부 대문자로 쓰는 것이 옳을 것이다.

어쨌든 usearch는 LS-BSR의 기본 클러스터링 도구이다. 다른 대안으로는 vsearch, cd-hit 등이 있다. 서열 클러스터링은 왜 하는가? 유사한 서열을 묶어서 데이터 분량을 줄이는 것이 주된 목적 중의 하나이다. Non-redundant sequence set을 작성하거나, 방대한 metagenome read를 처리하여 그 분량을 줄이는 것이 주된 application이다. 묶인 서열 클러스터에 대하여 하나씩의 대표 서열(representative sequence; usearch에서는 "centroid"라는 표현을 쓰는 것 같다)을 선정하거나, 혹은 consensus sequence를 만들어낼 수 있다. 아니면 클러스터에 속하는 모든 멤버 서열들을 그냥 나열하는 것도 가능하다.

그동안 상습적으로 blastclust를 써 왔는데 왠지 시대에 뒤떨어진 것 같다는 느낌이 들어서 오늘은 usearch를 살짝 사용해 보았다. 나와 비슷한 생각을 가진 사람이 또 있었는지 Biostars에 다음과 같은 글이 있다. 현재의 blast+ 패키지에는 blastclust가 빠져 있으니 그럴 생각이 들 만도 하다.
Questions: Blastclust has been deprieciated. Does anyone know why? (depreciated를 deprecated로 읽었다)
Usearch는 high-througput search & clustering 도구로서 Robert C. Edagr 박사가 개발하였다(웹사이트; usearch home 링크). 원래 그는 입자물리학 전공자로서 기업을 거쳐 2001년부터는 독립 과학자('independent scientist')로 일하고 있다. Usearch는 32 비트 버전의 경우 비상업적 용도로는 무료(소스 코드는 비공개), 64 비트 버전은 유료이다. 다중서열정렬 프로그램으로 유명한 muscle도 그가 개발하였다.

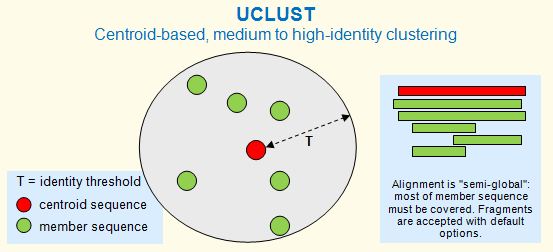
Usearch는  몇 가지의 클러스터링 알고리즘을 내장하고 있는데, 그중에서 usearch -cluster_fast 혹은 usearch -clust_smallmem 명령으로 기동되는 uclust에 대해서 좀 더 알아보자. 다음 그림은 uclust의 알고리즘을 한 눈에 잘 들어오게 보여준다(UCLUST algorithm). 웹사이트의 설명을 인용하자면 "A cluster is defined by one sequence, known as the centroid or representative sequence"이다. Ucluster는 단백질의 경우 identity ~50% 이상, 핵산의 경우 ~75% 이상인 서열에 적용하는 것이 바람직하다. Usearch가 제공하는 클러스터링 관련 모든 방법은 여기를 참고하라. Uclust는 2010년 Nucleic Acids Research에 "Searching and clustering orders of magnitude faster than BLAST"라는 논문으로 발표된바 있다(링크). 논문의 저자는 Robert C. Edgar 1인이다. 곳곳에서 'I'를 주어로 시작하는 문장이 보인다. 멋지지 않은가? 2002년 Genome Research에 실렸던 W. James Kent의 "BLAT-The BLAST-Like Alignment Tool" 논문(링크)도 그렇다.

https://www.drive5.com/usearch/manual/uclust_algo.html

클러스터 set는 다음과 같은 기준으로 만들어진다.
  1. 모든  centeroid의 서로에 대한 similarity는 T보다 작다.
  2. 클러스터 내 멤버 서열의 similarity는 centroid에 대하여 T와 같거나 크다.
OTU(operational taxonomic unit) clustering은 특별한 문제를 야기한다고 한다. Length sort를 하게되면 biological outlier를 centroid로 만드는 부작용이 유발되고, 종과 속을 다른 클러스터로 쪼개어서 alpha diversity를 뻥튀기하는 현상이 생긴다. 상세한 내용은 매뉴얼  페이지 혹은 2010년도 Bioinformatics에 실린 논문 "Search and clustering orders of magnitude faster than BLAST"를 참조하라.

Usearchf를 이용한 클러스터링의 기본 실행법은 다음과 같다(USEARCH command line).
usearch -cluster_fast seqs.fasta -id 0.9 -centroids nr.fasta -uc clusters.uc
화면으로 출력되는 메시지를 살펴보자.

00:00  42Mb  100.0% Reading HB03_20180914.ffn
00:00 8.7Mb Pass 1...2408 seqs, 2393 uniques, 2382 singletons (99.5%)
00:00 367Mb Min size 1, median 1, max 3, avg 1.01
00:00 370Mb done.
00:00 370Mb Sort length... done.
00:18 399Mb  100.0% 2391 clusters, max size 3, avg 1.0
00:18 399Mb  100.0% Writing centroids to HB03_nr.fasta
00:18 399Mb  100.0% Writing clusters                  
                                    
      Seqs  2393
  Clusters  2391
  Max size  3
  Avg size  1.0
  Min size  1
Singletons  2378, 99.4% of seqs, 99.5% of clusters
   Max mem  400Mb
      Time  18.0s
Throughput  132.9 seqs/sec.

두번째 줄에 표시된 수치는 이해하기가 좀 어렵다. 메시지 후반에 나온 확정된 수치를 참고하거나, 혹은 클러스터를 FASTA file로 출력하여 직접 서열의 수를 세는 것이 더 확실할 것이다. 2393개의 (unique) sequence라는 것도 어떻게 계산된 것인지 잘 모르겠다. Singleton이라 하면 클러스터링 후 멤버가 하나인 서열을 의미하는 것일텐데, 이것과 unique는 무엇이 다른 것일까?

-cluster_fast는 command, -centroids는 output option이다. 입력 FASTA file은 -cluster_fast 바로 뒤에 와야 한다. 클러스터 정보는 clusters.uc 파일에 기록된다. 이 파일의 포맷은 ucluster의 매뉴얼을 참조하라(링크). 클러스터를 구성하는 서열을 얻고 싶다면 다음과 같이 -cluster 옵션을 주어야 한다(cluster_fast에서만 작동). 그러면 cluster_dir 아래에 c_0, c_1, c_2...과 같은 서열 파일이 생긴다. 각 파일은 하나의 클러스터를 의미하며, 파일 내의 첫번째 서열이 바로 centroid가 된다. cluster_dir 디렉토리는 usearch 실행 전에 만들어 두어야 한다.
usearch -cluster_fast seqs.fasta -id 0.9 -clusters cluster_dir/c_
Usearch는 기본적으로 입력 파일에 존재하는 서열의 순서에 따라서 일을 한다. Fragment를 포함시키는 속성에 의하여 이것이 centroid로 쓰이게 되면 결과적으로는 매우 바람직하지 못하다. 따라서 -sort length 옵션을 적용하는 것이 좋다(UCLUST sort order). 다른 sort 옵션으로는 abundance가 있다. 정렬 순서는 큰 것에서 작은 순이다.

그러면 2016년에 발표된 vsearch(논문 링크; GitHub)는 무엇인가? 소스코드가 공개되어있지 않고 알고리즘 설명이 빈약한 usearch를 대신하고자 만든 open source tool이라고 한다.

마지막으로 CD-HIT를 빼놓을 수 없다(GitHub). 거대한 분량의 데이터를 초고속으로 다루는 cd-hit에는 다양한 핵심 프로그램과 스크립트가 포함되어 있다.

추가 작성: 2018년 10월 23일


위의 내용은 2018년 10월 23일에 대폭 수정되었다. 더불어서 새로 조사한 사항도 추가하고자 한다. 2011년도에 발표된 SiLiX 패키지라는 클러스터링 도구가 있었는데(링크) 크게 인기를 얻지는 못한 것 같다. 이를 개발한 프랑스에서는 꾸준히 사용되는 것 같다. 논문에서는 usearch나 uclust를 언급하지는 않았다.

프로그램 실행 방법을 소개한 리뷰 글 "How to cluster protein sequences: tools, tips and commands"도 소개해 둔다(링크).

2018년 2월 7일 수요일

일루미나 iSeq 100을 처음 접하다

지난 월요일부터 오늘까지 2박3일 동인 강원도 홍천에서 열린 제14회 한국유전체학회 동계 심포지엄에서 일루미나가 새롭게 출시한 iSeq 1000 Sequencing System을 접하게 되었다. 기존의 benchtop sequencing system으로는 MiSeq 제품군이 있지만 이보다 더 소형화를 이룸은 물론 단지 버튼을 누르듯이 간편하게 작동시킬 수 있도록 만들어졌다고 한다. iSeq이라는 이름은 아이폰이나 아이패드, 아이맥을 연상시킨다. 국문 소개 페이지는 여기에 있다. 캐치프레이즈는 "Your new lab partner"이다.


사진 속의 장비는 실제 작동이 되는 것은 아닌 일종의 mock-up이다. 터치식 화면은 실제 작동 상태를 흉내내고 있다. 손에 들고 있는 카트리지에는 시퀀싱을 위한 모든 시약이 이미 들어있다. Flow cell을 끼우고 사용자가 제작한 라이브러리를 로딩하면 끝이다. 러닝 시간은 9-17.5 시간이며 2 x 150 bp의 read를 약 1.2 Gb(4백만 read)를 생산한다. 일루미나 시퀀싱 장비의 비교표는 여기에서 볼 수 있다.

가격대는 qPCR machine 정도로 책정될 예정이라서 누구나 실험실에서 필요한 순간에 라이브러리를 만들어서 즉시 시퀀싱을 하게 만들자는 취지로 개발된 것으로 보인다. Throughput은 그렇게 높지 않아서 응용 분야는 제한되어 있지만 충분히 쓸모있고 흥미로운 장비가 아닐 수 없다. Oxford Nanopore Technologies의 MinION을 겨냥한 것일까?

심포지엄이 열린 비발디파크 메이플동 1층 전시실에서 만난 미술작품. 작가와 작품명은... 모르겠다. 벽을 향해서 한껏 스트레스를 날린 모습이다. 파파파팍!


NCBI PGAP이 생성한 공개 전 GenBank file을 Roary에 사용할 수 없는 이유

Pan genome 분석 파이프라인인 Roary는 유전체 서열 및 유전자(translated) 서열을 내부에 갖고 있는 GFF3 파일을 입력물로 받아들인다. 이를 위해서는 Prokka로 predictiongks GFF3 파일이나 NCBI에서 다운로드한 GenBank 파일을 bp_genbank2gff3.pl 스크립트(BioPerl에 포함)로 전환하여 사용하면 된다.

요즘 Paenibacillus polymyxa 및 이와 연관된 미생물 균주의 유전치 비교 분석에 힘을 쏟고 있다. 우리 연구그룹에서 유전체를 해독하여 NCBI의 PGAP으로 주석화를 하였지만 아직 공개가 되지 않은 것이 두 건 있어서 미공개 상태의 GenBank file을 genome submission portal에서 내려받은 후 bp_genbank2gff3.pl로 처리하여 GFF3 파일을 만들었다. 이를 다른 공개된 유전체 정보에서 전환한 GFF3와 한데 섞어서 Roary를 실행하였다.

그런데 core gene이 하나도 생성되지 않는 것이 아닌가. 처음에는 적절하지 않은 균주의 유전체 자료가 섞여 있어서 그러한 것이라 생각했었다. 나머지 것들과 너무나 거리가 먼 균주가 단 하나라도 섞여 있다면, 이들 전체를 아우르는 core gene이 나오지 않을 것임이 너무나 명백하다. 실제로 그러한지 확인을 하기 위하여 roary2svg.pl 스크립트로 gene_presence_absence.csv 파일을 처리하여 SVG(scalable vector graphics) 파일을 만든 다음 웹브라우저에서 열어보았다.


그게 아니었다. 비공개 GenBank file에서 생성한 GFF3가 제대로 쓰이지 못하고 있었다. 이 두 개의 유전체는 여러개의 contig로 구성된 것이다. 그게 Roary 작동에 문제를 초래하지는 않는다. GFF3 파일을 열어보니 contig 서열 ID가 있는 곳이 전부 '>noname'으로 표시된 것을 발견하였다. Contig가 몇 개이든 관계없이 전부 동일한 ID를 달고 있는 것이었다. 왜 그런 것일까? GenBank file의 앞부분으로 가 보았다. 하나의 contig에 대해서 다음의 정보가 나타나고(feature와 sequence를 포함), '//'를 구분자로 하여 다음 contig에 대해서도 LOCUS로 시작하는 새로운 정보가 이어진다.
LOCUS       <생략>
DEFINITION  Paenibacillus sp. F4, whole genome shotgun sequence.
ACCESSION
VERSION

DBLINK      BioProject: PRJNA429493
            BioSample: SAMN08348193
ACCESSION과 VERSION 난이 비어있다는 것이 원인일 것 같았다. 간단한 Perl 스크립트를 작성하여 이 부분을 LOCUS 값으로 채워 보았다. 비로소 정상적인 결과가 나왔다. 가까운 몇 개의 species에 속하는 균주의 데이터를 50개 가량 투입하여 분석한 것이라 core gene은 1070개 정도로 그 수가 조금 적다. 사소한 문제이지만 해결을 하니 속이 다 시원하다.

2018년 2월 3일 토요일

원핵생물의 subspecies는 어떻게 제안되는가

미생물의 학명에는 Bacillus subtils와 같이 속+종으로 구성된 학술적인 명칭 이외에도 var(variety), serovar, pathovar, subspecies(subsp.) 등의 정보를 뒤에 붙이고 있는 것이 많다. 이들 중에서 공식적인 명칭의 일부로 인정을 받는 것은 오직 subspecies 뿐이다. 그래서 subsp. 뒤에 오는 이름은 이탤릭체로 쓰는 것이 옳다. Subspecies는 동일한 종 내에서 유전적, 생리적, 또는 생화학적 특성에서 차이가 나는 세균의 하위 분류 단위를 의미한다.
Bacillus subtilis subsp. subtilisBacillus thuringiensis serovar israelensis
원래 ~var.는 끝에 약자임을 알리는 점(.)을 찍어야 하는데 잘 지켜지지 않는 것 같다. Variety는 변종을 의미한다. 원래 식물학, 원예학 등의 분야에서 이러한 용어의 정의가 만들어져 왔을 것으로 생각된다.  미국 아이오와 주립대 사이트에서 Cultivar versus variety라는 제목의 글을 발견하여 링크를 남긴다. 이 개념을 미생물 분류학 세계에 그대로 적용하는 것은 쉽지 않을 것이다.

미생물 분류학에 관련된 웹 자료는 이상하게 찾기가 힘들다. 오히려 수의(獸醫)미생물학과 관련한 곳에서(Nomenclature of bacteria) 읽기 쉬운 자료를 찾아내었다. 다른 종으로 보기에는 너무 유사하고, 동일 종으로 보기에는 너무 먼(가깝고도 먼?) 미생물에 대하여 학명 뒤에 subspecies epithet를 뒤에 붙이게 된다. Epithet란 별명 또는 형용어구를 의미한다. Genome sequence를 사용하여 두 균주가 동일 종인지 아닌지를 비교적 객관적으로, 그리고 재현성있게 판별할 수 있게 됨에 따라서 과거에는 어느 종의 subspecies로 여겨졌던 것이 완전히 다른 종으로 독립해 나가는 경우도 흔하다.
When you divide a species into several subspecies, the original species always gets the same subspecies epithet as the species epithet.
이는 무슨 말인가? 어떤 종을 몇 개의 subspecies로 나누게 될 경우, 원래의 종은 종소명을 species epithet로 갖게 된다. 예를 들어 설명하자. Bacillus subtilis에 subsp. spizizenii가 새로 제안되었다고 하자. 그러면 기존의 Bacillus subtilis는 Bacillus subtilis subsp. subtilis가 된다는 뜻이다.

여기서 잠시 종소명(種小名; specific name 또는 species epithet)에 대해 설명을 해야 되겠다. 린네가 제안한 이명법에서는 속명과 종명을 이탤릭체로 나란히 배열한다고 누구나 알고 있다. 그러면 Escherichia coli 중 Escherichi = genus, coli = species라고 생각하기 쉽다. 하지만 정확히 말하자면 coli는 종소명이다. 종(species)명은 언제는 Escherichia coli인 것이다.

FZB42(T)가 Bacillus amyloliquefaciens subsp. plantarum가 된 스토리

이틀 전 작성한 미생물 분류학 토막글 - (later) heterotypic synonym이란 무엇인가에서 한때 Bacillus amyloliquefaciens subsp. plantarum으로 불리던 FZB42 균주가 B. velezensis로 편입된 과정을 설명하였다. 지금은 더 이상 유효하지 않지만, FZB42 균주에게 plantarum이라는 subspecies epithet를 처음으로 제안하게 되었던 2011년 Rainer Borriss의 논문을 살펴보고자 한다.
Relationship of Bacillus amyloliquefaciens clades associated with strains DSM 7T and FZB42T: a proposal for Bacillus amyloliquefaciens subsp. amyloliquefaciens subsp. nov. and Bacillus amyloliquefaciens subsp. plantarum subsp. nov. based on complete genome sequence comparisons. [PubMed]
독일 브란덴부르크의 사탕무 토양(식물병이 창궐했던)에서 FZB13, FZB24, 그리고 FZB42라는 균주가 발견되어 학계에 보고된 것은 1998년이었다. 이 균주들이 식물의 성장을 촉진하는 것이 알려지면서 주목을 끌게 되었다. 이러한 성질은 plant-associated rhizobacteria가 나타내는 전형적인 특성 중 하나이지만 Bacillus subtilis DSM 10과 Bacillus amyloliquefaciens DSM 7(둘 다 type strain임)은 그렇지 않았다. 파지 감수성 실험에 의하면 B. amyloliquefaciens와 가깝다는 것이 확인되었지만 16S rRNA genes sequence, ribotype pattern, SfiI macrorestriction profile 등에서는 B. amyloliquefaciens DSM7(T)와 구별되는 특징을 보였다. 특히 FZB42는 전체 유전체의 8.5%이 다양한 secondary metabolite를 합성하는데 관여하고 있음이 밝혀졌는데, 이는 DSM7의 두 배를 능가하는 것이었다. DDH 실험에서도 63.7-72.1%의 DNA-DNA related value를 보여서 두 균주를 완벽하게 다른 종으로 구별하거나 한 종으로 간주하기에도 애매한 상황이다(2017년 논문에서 DSM7과 FZB42의 ANI 값은 94.61%로 발표함). 그래서 새로운 B. amyloliquefaciens subsp. plantarum을 제안하고 FZB42를 type strain에 위치시킨 것이다. 
"우리가 아는한 Bacillus 속 안에서 전통적인 미생물 분류법과 whole genome comparison을 이용하여 새로운 subspecies를 제시한 것은 이번이 처음이다."

2018년 2월 1일 목요일

미생물 분류학 토막글 - (later) heterotypic synonym이란 무엇인가

Bacillus amyloliquefaciens subsp. plantarum FZB42라는 균주가 있었다. 왜 '있었다'라는 과거형으로 표현하였는가? 지금은 전세계 어디에도 이 균주를 보관하는 culture collection이 없거나, 지구상에서 멸종을 했다는 뜻인가? 그런 문제는 다행히도 아니고, 공식 명칭이 바뀐 것이다.

분류학은 생명과학의 여러 분야 중에서 매우 독특한 학문이다. 생물체의 특성(해부학적, 생화학적, 유전체학적 등)을 주의깊게 관찰하고 체계화하는 것은 일반적인 과학의 단계와 같다. 분류학도 과학이니 가설을 입증하기 위한 실험을 하게 된다. 분류학에서 가설이란 이 생명체가 새로운 종인지, 또는 기존에 알려진 종과 얼마나 다른지에 대한 주장일 것이고, 따라서 분석 실험을 많이 진행하게 된다. 분류학이 다른 과학과 크게 다른 것은 매우 엄격한 규칙에 의존한다는 것이다. 물론 이 규칙은 새로운 지식이 발전하면서 계속 변한다.

나는 분자생물학이 국내에 맹렬하게 도입되던 시기에 공부를 하였기에 분류학에 대한 체계적인 교육을 받지 못하였다. 분자생물학·생화학은 모든 생명체를 아우르는 중심 원리에 집착한다. 반면 분류학은 거시적인 관점을 중요시하고, 동물·식물·미생물(아, 너무나 초보적이고 편견이 가득한 생명체의 분류 기준이여!)에 대해서 적용할 수 있는 방법이 천차만별이다. 현미경으로 겨우 보이는 세균에 손발이나 얼굴, 머리카락이 있는 것이 아니기 때문이다.

요즘 환경보호 이슈뿐만 아니라 각 국가가 고유하게 보유한 생물종의 전략자원화 추세에 따라 다시 분류학이 중요한 분야로 떠오르는 것 같다. 예전에는 정말 돈이 안되는 연구였다고 해도 과언이 아니니까 말이다. 어느 지역에 자생하는 어떤 식물에 혁신적인 신약 후보 물질이 있다고 하면, 그 식물을 제대로 구별해낼 수 있는 사람의 몸값이 올라갈 것이다. 학문적인 중요성이 아니라 경제적인 판단 기준에 의해서만 인정을 받으면 좀 아쉽긴 하다. 분류학 자체는 당연히 중요한 학문이다.

오늘 아침, Paenibacillus 종의 유전체 비교 분석을 하기 위한 바깥쪽 기준으로서 Bacillus amyloliquefaciens subsp. plantarum FZB42을 선택하여 그 서열 정보를 NCBI에서 찾아보았다. 이 균주는 식물체에 붙어서 사는(plant-associated bacterium을 이렇게밖에 표현하지 못하겠다) 그람 양성 세균으로서 식물의 성장을 촉진하며 항생물질로 활용할 수 있는 다양한 이차대사산물을 만들어낸다. 이미 다양한 미생물 비료 제품으로 만들어져 시판되고 있으며, 전체 유전체가 완전히 해독되어 2007년에 Nature지에 보고가 되었었다(논문 링크). 이 연구를 주도한 사람은 독일 훔볼트 대학에 근무하는 Rainer Borriss(ResearchGate)로서 현재 Bacillus와 Paenibacillus의 분류 및 comparative genomics 연구에 집중하고 있다. 연구 관심사가 나와 매우 유사하다. Bacillus는 16S rRNA gene seuqencing가 워낙 비슷해서 전통적인 방법으로 종을 구분하기가 까다롭기로 유명하다. 그래서 논문들을 추적하다보면 수시로 균주들이 이 종에서 저 종으로 옮겨다니게 만드는 제안을 많이 접하게 된다.

그런데 NCBI genome page에서 Bacillus amyloliquefaciens subsp. plantarum FZB42가 보이지 않는 것이었다. Bacillus amyloliquefaciens에 속하는 균주의 유전체 목록에 FZB42가 나타나지 않았다. 이게 도대체 어찌된 일인가? 몇년 전에 분명히 다운로드하여 잘 활용했었는데? 검색을 거듭한 결과 Bacillus velezensis로 명칭이 바뀐 것을 알 수 있었다. 그래서 이를 대신하여 B. amyloliquefaciens의 type strain인 DSM 7(free-living soil bacterium)의 유전체를 내려받아 사용하였다.

균주의 재분류 혹은 신종 보고 등에 관한 논문은 주로 International Journal of Systematics and Evolutionary Microbiology(줄여서 IJSEM이라 부른다)에 실린다. 여기에 실려서 공인을 받아야 비로소 어떤 균주의 명칭을 '공식적'으로 쓸 수 있고, 예전에 명명한 이름을 바꾸는 것도 이를 통해야 한다. 박테리아의 공인된 명칭 목록(approved list of prokaryotes)는 독일의 DSMZ나 LSPN bacterio.net에서 확인 가능하다. 공인되기 전까지는 "Bacillus gaemokensis"처럼 따옴표로 둘러쳐야 한다. 정확하게 표기하려면 이탤릭으로 표시해야 함은 물론이다. 여담이지만 요즘은 균주, 유전자, 유전자형, 표현형, 학명 등을 쓸 때 예전만큼 엄격하게 규칙을 지키지 못하는 것 같다.

FZB42가 다른 종 명칭으로 갈아타게 만든 근거가 된 논문은 2016년도에 IJSEM에 실린 다음의 논문이었다.

[1] Bacillus velezensis is not a later heterotypic synonym of Bacillus amyloliquefaciens; Bacillus methylotrophicus, Bacillus amyloliquefaciens subsp. plantarum and ‘Bacillus oryzicola’ are later heterotypic synonyms of Bacillus velezensis based on phylogenomics. (논문 링크)

분류학에 익숙하지 않은 사람(나를 포함하여)은 무슨 뜻인지 알기 어려운 제목이다. Bacillus velezensis는 B. amyloliquefaciens의 later heterotypic synomym이 아니라고 한다. 그러면 그 과거에는 later heterotypic synonym이었던 적이 있었나보다. 정말 그렇다!

[2] Bacillus velezensis is a later heterotypic synonym of Bacillus amyloliquefaciens. (2008년 논문 링크)

그리고 이 복잡한 관계를 정립하는 것으로 보이는 최근 논문이 2017년도에 나왔다. 역시 Borriss가 참여하였다.

[3] Bacillus amyloliquefaciens, Bacillus velezensis, and Bacillus siamensis Form an “Operational Group B. amyloliquefaciens” within the B. subtilis Species Complex. (논문 링크; PubMed가 아니라 PMC가 좋은 점은 논문 원문을 읽을 수 있다는 것이다)

자, 그러면 Bacillus를 둘러싼 복잡한 내력은 조금 뒤에 알아보는 것으로 하고, (later) heterotypic synonym이라는 가슴에 잘 와닿지 않는 용어를 공부해 보기로 하였다. 서울대학교 식물분류학연구실 장진석 교수님의 웹페이지에는 식물 분류와 관계된 자료를 많이 서비스하고 있다. 여기에서 용어 설명 페이지(링크)를 찾아가 보았다.

  • synonym 이명. [미정의] 같은 분류군에 적용되는 복수의 학명 중 1개(이형이명, 동형이명 참고)
  • homotypic synonym 동형이명(명명법상 이명). 학명이 다르지만 같은 기준표본에 근거한 학명(제14.4조); 국제동물명명규약과 국제세균명명규약(세균규약)에서는 각각 객관적 이명(objective synonym)으로 불림(제14.1조 각주)
  • heterotypic synonym (taxonomic synonym) 이형이명(분류학적 이명) 같은 분류군을 나타내는 학명과는 서로 다른 기준표본에 근거한 학명(제14.4조). 국제동물명명규약과 국제세균명명규약(세균규약)에서는 각각 주관적 이명(subjective synonym)으로 불림(제14.4조 각주)
실제 조항은 조류, 균류와 식물에 대한 국제명명규약(멜버른 규약 2012 번역 링크)을 참조하면 된다. 박테리아에 관한 규약은 어디에 있을까? NCBI Bookshelf에 있다(링크).

국문으로 된 자료를 접했다고 해서 '이형이명'이 쉽게 이해되는가? 영 그렇지 못하다. 자연계에서 순수하게 분리한 박테리아 표본이 있다고 가정하자. 이를 서로 다른 연구자가 별도의 과정을 통해서 나름대로 이름을 붙인 경우 그 중 하나가 동형이명이 되는 것으로 생각된다. 그렇다면 이명이형은? 그리고 'later' 이형이명은? 


가장 최근 논문인 [3]의 서론 부분을 읽어보았다. 2004년 Reva 등이 식물 혹은 토양에서 일곱가지의 B. subtilis group 균주를 분리하였다. 이들은 근권에서 잘 정착하여 자라면서(rhizosphere colonization) B. amyloliquefaciens의 표준 균주인 DSM7과는 다른 특성이 있었다. 여기에는 GB03과 FZB42가 있었다. GB03은 2014년 우리 연구그룹에서 유전체를 해독하여 짧은 보고를 한 적이 있다(링크). 새로운 종인 Bacillus velezensis는 1년 뒤인 2005년 신종으로 보고되었다(링크).

즉 FZB42는 B. amyloliquefaciens에 속하는 하나의 균주로 학계에 보고되었고 1년 뒤에 별도의 과정을 거쳐서 B. velezensis라는 종이 보고되었다는 것이다. B. amyloliquefaciens species가 제안된 것은 1943년인데, 실제로 공인된 것은 훨씬 뒤인 1987년이었다. 그런데 추후에 두 종의 type strain을 가지고 실험을 해 보니 "high DNA-DNA similarity and lack of phenotypic distinctive characteristics"에 의해서 B. velezensis를 B. amyloliquefaciens의 "later heterotypic synonym"이 되어야 한다고 주장한 것이 논문 [2]이다. B. velezensis BCRC 17467(T)와 B. amyloliquefaciens BCRC 11601(T) DNA 유사도(DDH 실험 결과)는 74%여서 다른 종으로 보기 어려웠다는 중요한 근거 중 하나가 되었다.

만약 B. amyloliquefaciens의 기준 표본(type strain과 동의어로 보아도 무방할 것이다)을 가지고 연구하던 사람이 이를 B. velezensis라고 명명했다면 아마도 homotypic synonym이라고 부르게 되지 않을까? 나는 최소한 이렇게 이해하였다.

그러면 다음의 어느 표현이 맞을까? 둘 다 맞을까, 아니면 어느 하나만 맞을까?

  1. Bacillus velezensis (syn. Bacillus amyloliquefaciens subsp. plantarum) (syn. Bacillus methylotrophicus) (syn. Bacillus methylotrophicus subsp. plantarum) (syn. Bacillus oryzae) 
  2. Bacillus amyloliquefaciens (syn. Bacillus velezensis) 
NCBI taxonomy 사이트에는 오직 (1)의 방식으로만 표기되어 있음을 알 수 있다(링크). 만약 (1)과 같이 표기한다면 먼저 공인된 종 명칭인 B. amyloliquefaciens가 매우 섭섭할 것이다. 그러나 아직 두 표기 형태 중 어느 것이 올바른지는 확신이 서지 않는다. 심지어 B. velezensis는 syn. B. oryzicola, 그리고 syn. B. methlotrophicus이기도 하다. 이는 논문[1]의 내용 중 하나이기도 하다.

왜 논문[1]에서는 B. velezensis가 B. amyloliquefaciens의 later heterotypic synonym이 아니라고 했을까? 저자들은 DDH 실험이 아니라 genome sequencing을 그 건거로 삼았다. B. amyloliquefaciens DSM7T에 대해서는 dDDH(digital DDH, 즉 genome sequence에 의한 계산; Genome-toGenome Distance Calculator 링크)가 55.5%에 불과한 반면, B. amyloliquefaciens (subsp. plantarum) FZB42T에 대해서는 85.8%였다. Sequencing에 의한 계산이 실제 DDH 실험을 이긴 셈이다.

어차피 B. amyloliquefaciens DSM7과 B. amyloliquefaciens (subsp. plantarum) FZB42T의 dDDH 계산수치는 56.2% 수준이었다. 이 논문으로 말미암아 B. velezensis는 B. amyloliquefaciens의 synonym을 벗어났고, 대신 B. amyloliquefaciens subsp. plantarum은 Bacillus velezensis의 later heterotypic synonym이 된 것이다. 또한 B. methylotrophicus와 'B. oryzicola' 역시 B. velezensis의 later heterotypic synonym이 되었다.

이제 논문[3]을 음미하면서 오랜만에 길게 쓴 글을 마무리하고자 한다. DSM7과 유사한 66개의 genome을 내려받아 비교한 결과(rpoB 유전자와 core genome sequence 사용) 이들은 (1) B. amyloliquefaciens, (2) B. siamensis, (3) a conspecific group(B. amyloliquefaciens subsp. platarum, B. velezensis, 그리고 B. methylotrophicus의 type strain을 전부 포함)의 세 개 그룹으로 묶을 수 있었다(근거로는 TETRA와 AAI). Monophyletic clade에 속하는 이 세 개의 그룹은 너무나 유사하여 종의 약간 상위에 존재하는 "operational group B. amyloliquefaciens"를 제안하였다. 비록 이들이 요즘 점점 중요성이 강조되고 있는 분석 기법인 ANI나 dDDH로는 한 종의 범주에 넣기에는 다소 곤란하다고 해도 말이다. 또한 이그룹은 식물과 더불어 살아가는 라이프스타일을 계쏙 발전시켜나가고 있는 중이며, 그러한 과정이 유전체에 남아있는 것이다.