2019년 2월 12일 화요일

POCP(percentage of conserved proteins): 세균의 속(genus) 구분을 위한 기준

두 미생물 균주가 같은 종(species)에 속하는지를 확인하는 지표로서 아직까지도 가장 널리 쓰이는 것은 16S rRNA 유전자의 서열 유사도(sequence similarity)이다. 두 균주의 16S rRNA gene sequence similarity가 97% 미만이면 이는 서로 다른 종에 속하고(역은 항상 성립하는 것은 아님), 95% 미만이면 서로 다른 속에 속한다는 것이다(Stackebrandt, E. & Goebel, B. M. (1994). Taxonomic note: a place for DNA-DNA reassociation and 16S rRNA sequence analysis in the present species definition in bacteriology. Int J Syst Bacteriol 44, 846– 849). 종 구별을 위한 서열 유사도 cut-off는 그 이후에 98.7%까지 올라갔고(Stackebrandt, E. & Ebers, J. (2006). Taxonomic parameters revisited: tarnished gold standards. Microbiol Today 33, 152–155), 2014년에는 98.65%가 기준값으로 제시되었다.

그러나 2015년 IJSEM에 실린 논문 "Cautionary tale of using 16S rRNA gene sequence similarity values in identification of human-associated bacterial species"에 의하면 inter-species sequence similarity 범위 95 & 98.7% threshold를 준수(?)하는 실제 사례는 그렇게 많지 않다고 한다. 이 논문의 저자들은 따라서 genus마다 고유하게 적용할 수 있는 sequence similarity의 범위를 사용할 것을 제안하였다.

유전체의 시대를 맞은 요즘 세균의 종 구분 지표로써 가장 널리 쓰이는 것은 두말할 나위 없이 ANI(average nucleotide identity)이다. 그러나 이 값은 속(genus)를 판별하기에는 적합하지 않다. Qin 등은 2014년에 50%의 POCP(percentage of conserved proteins)가 속 구분의 지표가 됨을 제안하였다.

J Bacteriol. 2014 Jun;196(12):2210-5. doi: 10.1128/JB.01688-14. Epub 2014 Apr 4.
A proposed genus boundary for the prokaryotes based on genomic insights. PMID 24706738

그림 출처: 링크. 같거나 다른 속 사이에서 16S rRNA gene identity나 ANI의 분포는 상당 부분 서로 겹친다.
그림 출처: 링크.

The percentage of conserved proteins (POCP) between two genomes was calculated as [(C1 + C2)/(T1 + T2)] ·  100%, where C1 and C2 represent the conserved number of proteins in the two genomes being compared, respectively, and T1 and T2 represent the total number of proteins in the two genomes being compared, respectively.

이 논문에서는 두 단백질을 서로 BLASTP로 검색했을 때 다음의 조건을 만족시키면 conserved protein인 것으로 간주하였다.
  • an E value of less than 1e−5
  • a sequence identity of more than 40%
  • an alignable region of the query protein sequence of more than 50%.
그러나 이 논문에서는 POCP 계산에 필요한 스크립트를 제공하지 않는다. Harris 등은 이에 따라 "Phylogenomics and comparative genomics of Lactobacillus salivarius, a mammalian gut commensal (링크)" 논문에서 POCP 매트릭스 산출에 사용했던 스크립트를 공개하였다. 실제의 스크립트는 figshare 사이트에 있다(DOI: dx.doi.org/10.6084/m9.figshare.4577953.v1). 봉사정신이 투철한 개발자가 이를 잘 손을 보아서 bioconda나 GitHub 같은 곳에서 배포하면 좋을 것이다.

[2019 오디오 자작] 6N2P 프리앰프 실험-III, 돌고 돌아 다시 43번 오극관에게...

이번에 만든 6N2P 프리앰프가 반도체 앰프와 연결하여 좋은 성능을 냈으니 43번 오극관을 사용한 전력증폭회로에 붙여서 쓰지 못할 이유가 없다. 그 동안 43번 앰프 회로는 OP amp를 이용한 드라이브단을 사용하고 있었다. 어제의 실험 회로는 다음 그림과 같다. 반도체를 전부 몰아내고 전부 진공관으로만 구성된 오디오 앰프를 추구하는 사람도 있다. 이 또한 확고한 철학을 기반으로 하는 목표이지만 전원부에서는 반도체 소자를 쓰지 않을 도리가 없다. 적어도 내 기술 수준으로는 그렇다.

이 회로도에서는 초단관(6N2P)와 출력관(43)에 각각 별도의 전원을 쓰는 것으로 그렸지만 꼭 그럴 필요는 없다. SMPS + DC-DC boost converter로 두 종류의 진공관에 B+를 전부 공급하니 가장 깨끗한 소리가 났다. 그 반대로 트랜스와 정류/평활회로를 사용하여 공급하면 볼륨을 최대로 할 경우 약간의 험이 들린다.

세상에 이렇게 엉성한 앰프는 없을 것이다. 기성품이 아니라 자작이라는 것이 더 이상 변명이 되지는 못한다. 그렇지만 내 귀에 듣기에 소리는 만족할만한 수준이다. 음량 조절용 가변저항을 드라이브단과 출력단 사이에 넣은 것이 좋은 선택이었던 것으로 생각된다. 43번 오극관의 바로 앞에 가변저항이 위치하여 그리드와 접지를 연결하고 있으므로 별도의 그리드 리크 저항은 필요하지 않다.

프리앰프부와 전원부.
43번 오극관 전력증폭회로를 연결하였다. 소리는 이만하면 OK.


6N2P 프리앰프에 별도의 섀시에 수납하지 않고 이 상태 그대로 유지하면서 실험용으로만 사용할 것인가? 혹은 43번 오극관 출력단과 하나의 앰프로 구성할 것인가? 만약 그러하다면 어떤 섀시를 만들까? 나무 도마 위에 늘어놓을까? 케이크 틀에서 도마에 이르기까지 주방와 관련된 물품보다 더 좋은 아이디어는 떠오르지 않는다.

2019년 2월 11일 월요일

[하루에 한 R] 리스트 생기초

data = c("a", "b", "c", "d", "e")라는 벡터가 있다고 가정하자. list(data)와 list("a", "b", "c", "d", "e")는 전혀 다른 구조의 리스트를 만들어 낸다.


data = c("a", "b", "c", "d", "e")
d1 = list(data)
d2 = as.list(data)
d3 = list("a", "b", "c", "d", "e")

as.list() 함수를 쓰지 않으면 인수로 주어진 벡터를 하나의 원소로 갖는 리스트를 만든다. 벡터의 개별 항목이 리스트의 원소가 되게 만들려면 as.list() 함수를 쓰거나, 혹은 list() 함수의 인수를 개별적으로 전부 나열해야 한다.

d2와 d3 리스트는 같은 동일한 구조이다.
d2(=d3) 리스트의 원소에는 아직 이름이 지어지지 않았다. 이름 정보를 수록한 벡터를 nato = c("Alpha","Bravo","Charlie","Delta","Echo")라 하면 names() 함수를 사용하여 이를 리스트의 각 원소에 부여하면 된다.


리스트를 생성하는 단계에서 이름을 부여할 수도 있다. setNames() 함수가 이러한 때에 쓰인다. 첫번째 인자가 벡터가 아니라 리스트임을 명시적으로 보여야 한다.


만약 실수로 as.list() 함수를 쓰지 않았다면 어떻게 될까? 그러면 단순한 named vector가 된다.


edit() 함수를 이용하여 실제로 이들 데이터 구조가 어떻게 선언되는지를 알아보자. 


만약 리스트의 원소 중에 벡터가 포함되어 있다면 모양이 좀 더 복잡할 것이다.


2019년 2월 10일 일요일

[2019 오디오 자작] 6N2P 프리앰프 실험-II

작년에 만들어 두었던 프리앰프 보드의 수정에 착수하였다. 입력측에 위치하던 음량 조절 전위차계를 출력쪽으로 옮기고 대신 grid leak 및 grid stopper resistor를 붙이는 것이 가장 큰 수정사항이었다. 출력측에 연결한 반도체 앰프의 전단에 이미 전위차계가 붙어 있어서 오늘의 실험에서는 커플링 캐패시터를 반도체 앰프의 입력에 직결하였다.

오늘의 실험에 사용한 6N2P 프리앰프 회로. 전원장치 회로도는 여기에 있다.

위에서 보인 '발로 그린 회로도'는 계산이나 검증을 거친 것이 전혀 아니다. 인터넷에 돌아다니는 심플한 프리앰프 회로를 적당히 짜깁기한 것에 불과하다. 다만 비교적 낮은 애노드 전압을 쓰는 회로를 좀 더 참고하였다. Triode / Pentode Loadline Simulator 사이트에서 힌트를 얻을 수 있을 것이다. 그리드 바이어스 전압의 측정치는 -0.65V 정도였다.

만능기판의 배선 모습을 사진으로 남겼다. 자세히 살펴보면 히터 점화용 전선의 연결 상태가 그다지 좋지 않다. 와이어 스트리퍼로 전선(연선)의 피복을 벗길 때 가장 짜증스러운 것은 심선 몇 가닥이 이와 같이 끊어질 때이다. 땜납으로 덧칠을 좀 더 해야 되겠다. 히팅 건이 없어서 라이터로 수축튜브를 가열해야 하니 항상 검게 그을음이 묻는 것도 마음에 들지 않는다. 해결 방법이 있기는 하다. 검정 수축튜브를 쓰면 된다...

페놀만능기판에 배선하는 한 이보다 더 간단하게 할 방법이 있을까? 회로 자체가 워낙 간단하기 때문에 하드 와이어링이든 고급 에폭시 기판이든 이런 수수한 배선과 비교하여도 음질에는 차이가 없을 것이라고 생각하였다.

반도체 앰프에 연결하여 소리를 들어 보았다. 반도체 앰프 자체의 게인이 워낙 높아서 음량 조절용 전위차계의 놉을 조금만 돌려도 매우 큰 소리가 났다. 전위차계가 프리앰프의 전단에 있을 때보다는 음량을 조절하기가 훨씬 수월하였고, 수정하기 전의 회로와 비교하면 훨씬 양호한 작동 상태를 보여 주었다. 히터 전원의 가상 중점을 접지에 연결했을 때 잡음이 줄어드는 효과는 명백하였다.


오늘 실험의 결과에 점수를 매긴다면 83점 정도? 만약 낙제점이 나온다면 다 거두어 넣고 앞으로 모든 오디오 자작 활동을 접을 생각까지 하던 차였다. '이번이 마지막'이라는 비장한 각오로 일을 벌이면 이처럼 실낱 같은 희망이 보인다는 것이 문제이다. 그래서 아직 유치한 수준의 이 취미를 손에서 놓지 못하는 것이다.


2019년 2월 8일 금요일

[하루에 한 R] read.table() 함수는 왜 #로 시작하는 라인을 읽지 못하는가?

데이터를 텍스트 형태로 수록한 자료 파일에서 주석(comment) 라인은 보통 첫번째 글자를 '#'으로 시작하는 경우가 많다. Shell 혹은 Perl script에서 주석을 달 때 쓰는 관행을 그대로 답습하는 것으로 보인다.

자료 파일의 중간에 주석을 넣을 수도 있지만, CSV(comma-separated values) 파일에서는 첫 줄에 컬럼의 이름에 해당하는 정보를 담기도 한다. antiSMASH database에서 다운로드한 파일의 사례를 보자. 확장자는 csv지만 실제 구분자는 탭이다. 첫 줄은 컬럼의 이름 정보를 싣는 동시에 '#'로 시작함으로서 주석임을 명시하였다.


이것을 read.table("file.csv",sep="\t",header=T)로 읽으면 어떻게 될까? '#Genus', 'Species', 'Strain'...이 컬럼 이름으로 들어가는 일은 절대로 벌어지지 않는다. 첫줄이 '#'로 시작하면 comment로 인식하여 읽어들이는 과정에서 그냥 지나가기 때문이다.

이를 제대로 읽으려면 다음과 같은 명령을 써야 한다.

data = read.table("file.csv",sep="\t",header=T,comment.char="")

read.table() 함수의 기본 동작은 comment.char="#"이다. comment.char에 지정할 수 있는 값은 당연히 단일 문자여야 한다. ""를 지정하면 모든 라인을 주석으로 해석하지 않는다. 읽어들인 파일이 데이터프레임으로 잘 전환되었는지를 확인해 보자.


왜 첫번째 컬럼의 이름이 X.Genus인가? 원본 파일의 값은 #Genus인데 특수문자가 있어서 이를 그대로 컬럼 이름으로 쓰기에 곤란하기 때문이다. 원본 파일의 #Genus를 AGenus, 1Genus, _Genus, 등으로 바꾸어 보면서 R이 이를 어떻게 적절히 컬럼 이름으로 변환하는지를 확인해 보라.

read.csv() 함수는 comment.char=""임을 기억해 두자. 주석이 없는 순수한 데이터값으로만 이루어진 파일을 읽어들이는 상황이 대부분일 것이라고 가정하여 동작한다는 의미가 아니겠는가?

함수의 용법을 정확히 하는 것 못지않게 데이터 파일을 텍스트 편집기로 한번쯤은 열어서 훑어보면서 헤더는 어떻게 구성되어 있는지, 중간에 주석줄은 없는지 등을 확인해 보는 것이 현명할 것이다.

2019년 2월 7일 목요일

[2019 오디오 자작] 6N2P 프리앰프 실험

모든 전자장치 DIY의 기본은 전원회로를 잘 만드는 것에서 시작한다. 1N4007(위키피디아) 네 개를 평면 상의 사각형 모양으로 엮어서 만든 정류용 브리지를 어떻게 매만져야 보기에도 좋고 공간도 적게 차지할지 고민한 끝에 다음과 같은 최종 결과물을 얻었다. 왼쪽이 교류 입력, 오른쪽이 정류된 직류(정확히 말하자면 맥류) 출력에 해당한다. 직육면체를 구성하는 평행한 네 개의 모서리에 다이오드가 하나씩 위치하게 만든 것이다.


만능기판에 브리지 정류회로를 구성해도 되지만 생각을 게을리하면 예쁜 배선 패턴이 나오질 않는다. 잠시 검색을 통하여 모범이 될만한 패턴을 찾아보았다. 다음의 것이 아주 적당하다.
출처: http://hkpinvent.blogspot.com/2013/

알리익스프레스에서 구입한 뒤 아직 만들지 않은 정류회로 보드의 패턴도 옮겨서 그려 보았다. 위상수학의 관점에서는 위의 것이나 아래의 것이나 똑같은 그림일 것이다.


2019년 설 연휴의 끝자락에 이루어진 이번 DIY에서는 6N2P를 사용하여 만들었던 프리앰프부 회로가 과연 쓸만한 물건인지를 알아보자는 것이 목표였다. 전원부는 보유한 부품을 최대한 활용하기로 하였다. 43 pentode 싱글 앰프에서 12AU7을 꽂아서 드라이브 회로로 썼다가 갑자기(?) 발생한 극심한 잡음으로 인하여 퇴출이 된 상태였다. 12AU7은 그 후로 몇 번 점검을 했지만 상태가 좀 이상한 것 같아서 갖고 있던 4개의 6N2P 중 하나를 쓰기로 했다.

6N2P를 사용한 프리앰프 회로 중 가장 모범적(?)인 것은 다음과 같다.

출처: How to use 6N1P and 6N2P Russian tube

이 프로젝트를 구상하면서 처음에 참조한 회로도는 Matt Renaud의 4S universal tube preamplifier for 12A*7 tubes이다. 여기에서는 캐소드 바이패스 캐패시터가 선택으로 되어 있고 음량 조절용 폿은 출력부에 위치한다. 위에서 보인 6N2P 회로와 비교하면 바이어스 저항의 값이 가장 많이 다르다.

최근에 참조한 회로도는 다음과 같다("an example of a 20 dB audio gain stage"). B+ 전압은 50-150V를 권장하였다.

출처: Hackaday

6N2P를 비교적 낮은 B+ 전압으로 구동하려면 나머지 부품의 수치는 어떻게 해야 하는가? 6N2P tube pre-tone low volt & low cost라는 글을 참조하면 약간의 아이디어를 얻을 수 있다. 출력측은 커플링 캐패시터에서 그대로 뽑아내는 것이 아니라 몇 가지의 수동 부품이 여러개 엮여진 다소 복잡한 형태이다. 뭔가 이유가 있을 것이다.

출처: 6N2P tube pre-tone low volt & low cost

그러나 부품을 교체하는 일은 하지 않았다. 계산과 실험에 의해서 최적의 부품값을 결정해야 하는데, 너무 주먹구구로 일을 하고 있다! B+ 전압, 더욱 정확히 말하자면 anode voltage(Va or Vak)가 낮아지면 그리드 바이어스 전압을 높여야(0에 가까와지도록) 하므로 당연히 캐소드 저항치도 작아져야 할 것이다(맞나??).

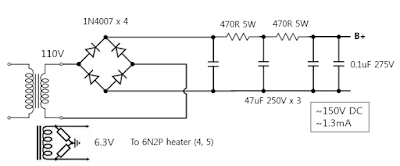
전원회로를 직접 만들어야 하는데 마침 내가 갖고 있는 캐패시터 중 내압이 가장 높은 것은 250V가 고작이다. 어떻게 할 것인가? 전원트랜스(1차 220V, 2차 230V + 6.3V, 링크)의 2차에 강압용 단권트랜스(1차 440V-380V, 2차 220V-110V, 링크의 사진에서 오른쪽)을 뒤집어 연결하여 115V 정도를 얻어내는 것으로 결정하였다(아래 회로도). 다이오드 브리지의 모습은 이 글의 도입부에서 소개하였다. 저항과 캐패시터는 하드와이어링으로 대충 연결하였고, 최종단의 0.1uF 캐패시터는 다른 회로에서 떼어낸 Dain MPX 275VAC(metallized polypropylene film capacitor)를 재활용하였다. 갖고 있던 세라믹 캐패시터는 내압이 낮아서 쓸 수가 없었다.


대충 만든 앰프에서는 대충 소리가 난다.. 아직은 그렇게 만족스러운 수준의 소리가 아니다. 앞으로 이 실험용 프리앰프가 삼극관을 이용한 전압증폭회로(기본 중의 기본!)를 공부하는데 좋은 교재가 될 것으로 믿는다.


2019년 2월 3일 일요일

[하루에 한 R] Key/value 형태의 자료를 이용한 치환 - named vector 이야기

Perl에서는 hash라는 자료형을 이용하여 key/value 형태의 자료를 다룬다.


$color_of{apple} = 'red';
# initialize a hash
my %color_of = (
    "apple"  => "red",
    "orange" => "orange",
    "grape"  => "purple",
);

R에서는 이와 유사한 자료 구조로서 list가 있지만 hash보다는 훨씬 복잡한 구조의 데이터를 담을 수 있다. 예를 들어서 list_data = list("red","green",c(1,2,4), TRUE,13.43)의 사례에서 볼 수 있듯이 문자열, 숫자, 벡터, 논리값 등 어떤 타입의 원소든지 담을 수 있다. 물론 Perl의 hash에서도 참조(reference)를 이용하면 어떤 자료형이든 scalar로 전환되므로 hash의 값으로 저장할 수 있다. Perl의 hash에서는 각 원소에 접근하려면 key를 사용해야 되지만, list는 훨씬 다양한 방법으로 인덱싱하여 접근하거나 혹은 슬라이싱이 가능하다.

이번 글에서는 R에서 key/value 목록을 사용하여 간단하게 데이터를 변환하는 방법을 알아보고자 한다. 알파벳 소문자 a, b, c, d, e를 NATO 음성 문자(NATO phonetic alphabet) alpha, bravo, charlie, deltam echo로 변환하는 아래의 사례에서는 list를 쓰지 않고도 named vector를 사용하고 있다. Perl의 사고 체계와는 약간 다르다는 것을 이해해야 한다. Perl에서는 $hash{key} = value의 형태로 자료를 정의하므로 특정 key에 해당하는 value를 확인하는 과정이 복잡하지 않다. 그러나 R의 named vector에서는 names(var)[var=="key"] 구문을 사용해야 key에 대응하는 value가 반환된다. 언뜻 난해해 보인다.

> abcde = c("a","b","c","d","e")
> nato.abcde = c("Alpha","Bravo","Charlie","Delta","Echo")
> names(abcde) = nato.abcde
> abcde
  Alpha   Bravo Charlie   Delta    Echo 
    "a"     "b"     "c"     "d"     "e" 
> names(abcde)[abcde=="a"]
[1] "Alpha"
> data = c("e","e","a","b","c","d")
> for(i in data){print(names(abcde)[abcde==i])}
[1] "Echo"
[1] "Echo"
[1] "Alpha"
[1] "Bravo"
[1] "Charlie"
[1] "Delta"

내용상으로 value에 해당하는 것이 names() 함수의 값으로 반환되는 것이 좀 어색하다. 왠지 names()로 지정 또는 반환되는 값은 key에 해당하는 것이 더 자연스러울 것이라는 생각이 든다. 다시 말해서 "a"를 입력했을 때 "Alpha"를 얻고자 한다면, 다음 중 어느 것이 더 자연스럽겠는가? 두 경우에서 myVar 벡터의 구조는 서로 정반대이다.

  1. result = myVar["a"] 
  2. result = names(myVar)[myVar=="a"]

두말할 나위도 없이 (1)번이 더 직관적이다. 하지만 이 글의 윗부분에서 든 사례에서는 (2)의 방식을 택하고 있다. 어떤 방식이 더 낫다고는 할 수 없다. 다만 어떤 벡터 원소의 이름은 그 원소의 속성 중 하나라고 이해하면 (2)의 방법도 수긍이 간다. 위에 보인 R 코드에서 abcde를 입력했을 때 화면으로 출력되는 자료의 모습을 한번 음미해 보자. Alpha, Bravo, Charlie...는 마치 데이터프레임의 column label과 흡사하다. 이러니 혼동을 불러 일으키는 것도 당연하다.

좀 더 현명한 방법은 아래와 같이 list를 사용하는 것이다. setNames() 함수를 사용하면 리스트를 생성하면서 동시에 이름을 부여할 수 있다(괄호 안에서 as.list() 함수를 쓰지 않으면 단순한 named vector가 된다). 여기에서는 names()가 가리키는 방향이 위의 named vector의 사례와는 반대임을 유의해야 한다. 즉, key에 해당하는 것을 가리킨다.

> myList = setNames(as.list(nato.abcde),abcde)
# myList = list(a="Alpha",b="Bravo",c="Charlie",d="Delta",e="Echo")
# add a new key/value element > myList$f = "Foxtrot" > myList[["h"]] = "golf" > names(myList)[names(myList)=="h"] = "g" > for (i in ls(myList)) {print(myList[[i]])} [1] "Alpha" [1] "Bravo" [1] "Charlie" [1] "Delta" [1] "Echo" [1] "Foxtrot" [1] "golf" > for (i in data) {print(myList[[i]])} [1] "Echo" [1] "Echo" [1] "Alpha" [1] "Bravo" [1] "Charlie" [1] "Delta"

'펄(Perl)'과 '알(R)'의 짤막한 비교언어학이었다.

[업데이트 2019-02-18] 실용적인 사례


위에서 보인 예문에서는 for 반복문 안에서 단지 print를 이용하여 값을 화면에 인쇄한 것에 지나지 않는다. 실제로는 data = c("e","e","a","b","c","d")라는 벡터가 주어졌을 때 각 원소를 이에 대응하는 "Echo"    "Echo"    "Alpha"   "Bravo"   "Charlie" "Delta"로 바꾸어 벡터로 반환해 주어야 비로소 쓸모가 있다. Named vector를 사용하여 간단하게 처리하는 코드를 소개해 본다. Named vector 'abcde'는 위에서 정의한 것을 그대로 사용한다. 변환 작업을 할 벡터 data가 주어졌을 때 여기에 원소와 동일한 이름을 붙이는 것이 핵심이다.

> abcde = c("a","b","c","d","e")
> nato.abcde = c("Alpha","Bravo","Charlie","Delta","Echo")
> names(abcde) = nato.abcde
> data = c("e","e","a","b","c","d")
> names(data) = data
> for (i in data) {
+ temp = names(abcde)[abcde==i]
+ names(data)[names(data)==i] = temp
+ }
> names(data)
[1] "Echo"    "Echo"    "Alpha"   "Bravo"   "Charlie" "Delta"  

위의 방법에서는 data vector의 이름을 변경하였다. 이름과 값이 동일하다면, 값을 바꾸어도 된다. 맨 마지막 행에서는 unname() 함수를 사용하여 data 벡터의 이름을 제거해야 원하는 결과가 나온다.

> data = c("e","e","a","b","c","d")
> names(data) = data
> for (i in data) {
+ temp = names(abcde)[abcde==i]
+ data[names(data)==i] = temp
+ }
> unname(data)
[1] "Echo"    "Echo"    "Alpha"   "Bravo"   "Charlie" "Delta"  

named vector에서는 이름이 같아도 문제가 되지 않는다. 아마 data frame에서는 곤란할 것이다.