2018년 10월 24일 수요일

블로그 포스트에 코드 조각 삽입하기

코드 조각(code snippet)을 블로그 포스트에 예쁘게 삽입하려면 정성을 기울여야 한다. 한때 Syntax Highlighter를 써 보려고 노력했지만 블로그의 템플릿을 수정하는 것도 까다로웠고 실제 적용한 뒤에 페이지를 로드해 보면 제대로 불러오는데 시간이 많이 걸린다는 느낌이 들었다.

좀 더 간편한 방법은 없을까? Stack Overflow에서 그 해답을 찾았다.

Formatting code snippets for blogging on Blogger

첫번째는 hilite.me 웹사이트를 이용하는 것이다. 웹사이트 주소도 아주 외우기 쉽다. '하이라이트 미' 아니겠는가? 여기를 방문하여 소스코드 창에 원하는 코드 조각을 입력하고 언어의 종류와 스타일을 결정한 뒤 나오는 HTML 코드를 복사하여 블로그 편집창에 넣으면 된다. 이렇게 말이다. 편집모드는 HTML로 놓는 것이 좋다.


#!/usr/bin/perl

while (<>) {
    chomp;
    my @data = split /\t/, $_;
    print "$data[0]: $data[3]\n";
}

이러한 용도의 웹사이트는 몇 군데가 더 있다.
또 다른 사용자는 다음의 css 스크립트를 복사하여 쓰는 것을 제안하였다. 중간의 블록에 코드를 삽입한 다음 이를 그대로 블로그 편집창에 넣으라는 것이다. syntax highlighting 기능은 없지만 소스 코드를 그대로 보이는 데에는 유용하다. 매우 단순한 방법이다.

 <pre style="font-family: Andale Mono, Lucida Console, Monaco, fixed, monospace; 
                color: #000000; background-color: #eee;
                font-size: 12px; border: 1px dashed #999999;
                line-height: 14px; padding: 5px; 
                overflow: auto; width: 100%">
       <code style="color:#000000;word-wrap:normal;">

            <<<<<<<YOUR CODE HERE>>>>>>>

       </code>
 </pre>

이를 한 번 적용해 보았다.

#!/usr/bin/perl

while (<>) {
    chomp;
    my @data = split /\t/, $_;
    print "$data[0]: $data[3]\n";
}       

블로그 문서 내에서 '<'과 '>'을 제대로 표시되게 하는 것은 여전히 어렵다. 몇 번씩 '미리보기'로 확인을 해야 하니까 말이다. 오늘 찾은 방법은 잘 기억해 두었다가 활용하도록 하자.

2018년 10월 23일 화요일

Protein sequence clustering과 dN/dS 분석

새로운 과제를 시작하면서 단백질 서열 클러스터링이라는 매우 고전적인 일을 하게 되었다. 단백질 패밀리의 분석, pan-genome 계산, ortholog 추출, dN/dS 분석, 데이터셋의 크기 축소 등 단백질 클러스터링은 매우 여러 분야에 쓰인다. 자료를 조사하면서 지난 2월에 작성했던 글인 Usearch 맛보기도 업데이트하였다. 오늘 작성하는 글은 "How to cluster protein sequences: tools, tips and commands"을 많이 참고하였다.

단백질 서열 클러스터링 기법은 크게 다음의 두 가지로 나눌 수 있다.
  • Sequence-based clustering: CD-HIT, UCLUST, USEARCH...
  • Graph-based clustering: LAST, legacy BLAST, BLAST+...
  • Network clustering: MCL
Graph-based clustering에서는 모든 단백질 서열 사이의 1:1 similarity 정보를 얻어내는 것이 필요하다. BLAST 계열의 프로그램을 사용하는 경우 결과물을 파싱하여 Reciprocal Best BLAST hit(RBB, RBH, or biodirectional best hit BBH)을 추출하여 활용하면 되는 것이다. RBB는 두 genome 사이에서 ortholog candidate를 산출하는 데에도 널리 이용된다.

RBH으로부터 ortholog를 정확하기 추출하기 위한 BLAST option을 제안한 논문이 2008년에 발표된바 있다(PMID: 18042555). 이를 기반으로 하여 다음의 BLASTP 옵션이 제안되었다. 논문에서는 첫번째 조건만을 제안하였다. 이렇게 함으로써 ortholog의 수는 가장 많게, 그러나 error는 최소화할 수 있었다고 한다.
  • -F "m S" -s T (combination of soft filtering and Smith-Waterman final alignment)
  • E value: 10-5 또는 10-6 이하
BLAST 프로그램은 database search와 alignment의 두 단계로 이루어지는데, soft filtering이란 첫번째 단계에서만 low-complexity sequence를 마스킹하는 것을 의미한다(-F "m S"). 기본 조건은 -F T -s F이다. -F "m S"라는 옵션이 있다는 것은 blastall의 모든 옵션이 수록된 페이지(링크; 혹은 명령행에서 blastall이라고만 치면 나오는 텍스트)에서 찾아보기 어렵다.

이상의 옵션은 legacy BLAST에 대한 것이다. 그러면 요즘 권장되는 BLAST+에서는 무엇이라고 옵션을 제공해야 하는가? NCBI의 매뉴얼 페이지(링크)를 참조해 보면 -soft_masking T -use_sw_tback (-evalue 10-5)일 것으로 추청된다. 

다음의 북 챕터에서는 BLAST+를 이용하여 상동유전자 정보를 찾고, 이로부터 dN/dS 분석일 실시하는 방법을 친절하게 설명하였다. 사용된 Perl script(BLAST+ 결과물에서 RBB를 추출하는 스크립트 포함)는 제1저자인 Daniel Jeffares의 웹사이트에서 입수 가능하다고 해 놓았다.

A Beginners Guide to Estimating the Non-synonymous to Synonymous Rate Ratio of all Protein-Coding Genes in a Genome. Methods Mol Biol. 2015;1201:65-90. doi: 10.1007/978-1-4939-1438-8_4. PMID.

그러나 지금 이 사이트를 방문해보면 figshare에 Perl 스크립트 일부만이 남아있다. 그러나 Daniel은 이를 기반으로 하여 VESPA라는 파이프라인을 개발하여 2017년 PeerJ Comput. Sci.에 발표하였다(VESPA: Very large-scale Evolutionary and Selective Pressure Analyses. 저널 GitHub 매뉴얼). VESPA를 공부하려면 단순히 RBB를 찾으려는 목적이 아니라 더 큰 안목을 가지고 착수해야 할 것이다.

InParanoid를 사용해서 두 단백질 세트 사이에서 ortholog를 찾을 수도 있다. 그런데 Why InParanoid sucks라는 글(2014년도)을 보니 이제는 이 프로그램을 떠나야 하는 것이 아닐까하는 생각도 들기 시작하였다. 알고리즘적으로 특별히 문제가 되는 것은 아니지만 말이다. 어쩌면 blast_rbh.py 스크립트가 바로 내가 찾던 것이 아닌지 모르겠다. 이를 다운로드하여 실행해 보았다. duplicate가 있다는 경고는 나오지만 결과 파일에서 이들이 어느 것인지를 보여주지는 않는다. 상동유전자를 찾는 프로그램으로서 GET_HOMOLOGUES도 유용한 프로그램으로 여겨진다.


$ ls
A.faa  B.faa
$ python ~/script/blast_rbh.py -o example.tab -t blastp -a prot A.faa B.faa 

Done, 10 RBH found
Warning: Sequences with tied best hits found, you may have duplicates/clusters
$ ls
A.faa  B.faa  example.tab
$ head -n 1 example.tab 
#A_id B_id A_length B_length A_qcovhsp B_qcovhsp length pident bitscore

BLAST+ 분석 결과물에서 best hit(RBB는 아님)을 추출한 뒤 mcl로 클러스터링하는 명령행을 정리하여 보았다. 이는 서두에서 언급한 참고문헌에서 발췌한 것이다.

$ makeblastdb -in DB.fasta -dbtype prot -out DB
$ blastp -query example.fasta -db DB -outfmt '6 std qlen slen' -out output_tmp.list -evalue 1.03e-05
$ awk '{if($1!~/^#/ && $3>=50) print $1"\t"$2"\t"($3/100)}' output_tmp.list > hits.list
$ sort -nrk 3 hits.list | sort -k 1,2 -u > best_hit.list
$ mcl hits.list -I 1.8 --abc -o clusters.txt
$ awk '{if(NF>=2) print}' clusters.txt > clusters_after_threshold.txt

맨 아래의 awk 명령어는 singleton을 제거하기 위함이다.

마지막으로 대용량의 pan-genome 분석을 위한 새로운 프로그램을 하나 소개해 본다. 늘 Roary만 편식을 심하게 했었는데 이제는 다른 것에도 눈을 돌려볼 때이다.


2018년 10월 21일 일요일

독서 기록 - [디스럽션] 외 세 권

대출 기간이 임박하여 책 표지 사진을 찍은 뒤 곧바로 반납을 해 버려서 간단한 서지정보만 남긴다.


디스럽션

  • "사물인터넷 비즈니스의 모든 것"
  • 저자: 강시철
커넥슈머, 프라이버시 스왑...

모든 교육은 세뇌다

  • "4차 산업혁명 시대의 경쟁력, 몰입의 힘"
  • 호리에 다카후미 저|박흥규 감수|하진수 역
도서관에는 아직도 '4차 산업혁명 관련 도서' 서가가 따로 마련되어 있다. 과연 이 유행어가 내년까지 갈지 두고 보아야 되겠다.

다시 읽는 한국 현대사

  • "정치의 새로운 실천을 기대하며"
  • 양우진 저
근대사의 전 과정을 부정의 역사로 보는 진보 진영의 시각에 대한 보수주의자의 비판. 시각을 넓혀보자는 차원에서 고른 책이다.

열한 계단

  • "나를 흔들어 깨운 불편한 지식들"
  • 채사장 저(책 소개)
이 책을 읽기 전까지는 채사장(팟캐스트 지대넓얕 진행자, 블로그)을 전혀 몰랐다. 지대넓얕이란 '지적 대화를 위한 넓고 얕은 지식'을 뜻한다. 알쓸신잡보다 먼저 만들어진 낱말인가? 인문학 = 교양이 아니다. 인문학은 그 자체로서 의미가 있는 것이지 치장을 위하여 '소비'되는 것이 아닌데.. 물론 저자의 노력을 폄훼하고자 함은 아니다. 

한자 丁에는 '고무래'라는 뜻이 전혀 없다

丁 넷째 천간 정, 장정 정

단 두 획으로 이루어진 매우 간단한 모양의 한자이다. 장정이란 한 사람의 일꾼 몫을 하는 어른 남자를 뜻한다. 군대에 갈 연령, 즉 징집 연령에 달한 남자를 뜻하는 것이기도 하다.

이 한자는 한국 또는 중국인의 성씨에도 쓰인다. 우리 집안의 성이 바로 이 한자를 쓴다. 인구 비율로 훨씬 많은 鄭(나라 정, 나라 이름 정)과 구별하기 위해 흔히 丁자를 ‘고무래 정’이라고 부르기도 한다. 고무래는 곡식 낱알 등을 긁어모으는 농기구의 일종으로 이 글자와 모양이 똑같다.

그러나 이 글자 자체에 고무래라는 뜻(訓)은 전혀 없다는 것이 나의 상식이었다. 과거에 분명히 한자사전에서 이러한 설명을 보았었다. 심지어 어떤 사람이 丁자를 ‘갈고리 정’이라고 부르는 바람에 아연실색을 한 적이 있었다. 남의 성씨를 마치 공포영화에 나올 법한 흉칙한 물건으로 칭하다니!

며칠 전에 컴퓨터를 만지작거리면서 호기심에 丁자의 의미를 검색해 보았다. 그런데 놀랍게도 ‘고무래’라는 뜻이 있는 것으로 나타나지 않는가?

먼저 네이버 한자사전. ‘고무래’라는 뜻이 맨 위에 있다.

네이버 한자사전 캡처

다음 사전. 여기에는 정확하게 풀이하였다. ‘※ 흔히 「고무래 정」이라 칭하는 것은 글자 모양에 따른 속칭임.’이라는 추가 설명이 달려 있다.

다음 사전 캡처

나무위키. 여기도 고무래를 맨 위 뜻으로 올려 놓았다.

나무위키 캡처

이외에도 한자 학습 사이트에서 丁자가 ‘고무래’를 뜻한다고 기록한 경우가 많다. 이는 잘못된 정보이다. 마치 ‘입 구(口)’자를 네모를 닮았다 하여 ‘네모 구’라 부르다가 인터넷 사전에 ‘네모’라는 뜻으로 등재하는 것과 다르지 않다.

정말 내가 알고 있는 丁의 뜻이 맞는지 확인하기 위해 직접 도서관에서 민중서림 한자대사전(전면개정·증보판)을 찾아보았다.

한자대사전 사진

그 어디에도 ‘고무래’라는 뜻은 없다. 글자의 본래 모양은 ‘못’이지 ‘고무래’가 아니다. 게다가 ‘고무래정으로 훈함은 잘못’이라고 명기되어 있다. 홍윤표 교수 또한 이 한자에 ‘고무래’ 해석이 사용된 적이 없음을 분명히 하였다(‘사나이’의 어원).

사실에 기반하지 않은 엉터리 지식이 인터넷에서 떠돌며 진짜 지식으로 둔갑하는 것이다. ‘인터넷에서 보았다’는 것은 그 지식의 정확함을 입증하지 못한다.

2018년 10월 18일 목요일

구글플러스 검색법

블로그로 작성한 글은 별도의 검색창이 있으니 찾는데 그렇게 큰 수고가 들지 않는다. 하지만 구글플러스에 내가 쓴 글을 찾는 방법을 아직도 잘 모르고 있었다. 연주회가 끝나고 기타연주자 박규희 씨와 찍은 사진을 구글플러스에서 찾느라 애를 먹은 적이 있었다.

구글을 로그아웃한 뒤 구글 검색창에 숫자로 된 내 아이디를 넣으면 내가 쓴 공개글이 다 보인다고 한다. 이외에도 몇가지 유용한 팁이 다음에 소개되어 있다.

https://plus.google.com/+googlekorea/posts/XND1ENoA3Mc

Whizz Xanadu 님이 쓴 글이다.

그런데 구글플러스 숫자 계정을 어떻게 확인해야 할까? 구글플러스 -> 프로필을 클릭하면 주소창 맨 끝에 숫자 계정이 잠깐 나왔다가 순식간에 '+영문이름'으로 바뀐다. 너무나 당연하고 간단하지만, 평소에는 일부러 찾아보지를 않으니 알 수가 없다.

또 검색을...

이렇게 짧은 글을 구글플러스가 아니라 블로그에 남기는 것은 나중에 쉽게 검색을 하기 위함이다. 아, 부끄럽다.

Plasmid Profiler 삽질기

100 건이 넘는 다제내성 Acinetobacter baumannii의 MiSeq read에 대해서는 잘 돌던 Plasmid Profiler가 40 건의 대장균 시퀀싱 결과물에 대해서는 에러를 토해내었다. 벌써 며칠째 제자리 걸음인지를 모르겠다. Plasmid Profiler를 제외하면 Galaxy를 쓰지 않으니 익숙하지 않은 시스템에서 출력하는 에러 메시지를 접해도 해결하기는 곤란할 것이라고만 짐작하였다.

파이프라인의 맨 끝까지 가서 png/html/csv 파일을 만들어내는 R 스크립트가 제대로 결과를 내지 못하는 것이 직접적인 이유였다. 이 스크립트는 사용자가 워크플로우를 실행하면서 입력하는 4 가지 파라미터 이외에 두 종류의 중간 결과 파일(BLAST TSV, SRST2 TSV)을 이용하게 된다. 에러 메시지를 직접 확인해 보았다. BLAST TSV 파일을 파싱하는데 서열 중간에 하이픈이 있다는 것이다. Plasmid Profiler가 기본적으로 제공하는 DB 파일은 플라스미드 서열 및 replicon + AMR(antimicrobial resistance) 서열 파일의 두 가지이다. 그런데 두번째 파일에서는 기본 제공된 AMR gene이 얼마 되지 않는다. 그래서 내가 ResFinder에서 항생제 내성 유전자 서열을 가져다가 기존 DB 파일 뒤에다가 추가를 한 뒤 사용을 했었다. 에러가 발생한 FASTA file의 라인 번호를 찾아가 보았다.


어라? '>'가 나오는 위치에서 줄바꿈을 하지 않은 것이었다. 이 라인은 줄을 바꾼 뒤 다음과 같이 시작하도록 고쳐야 한다.

>(AMR)mcr-1_1_KP347127

Acinetobacter baumannii의 시퀀싱 결과물을 분석할 때에는 이 AMR gene에 대한 hit가 없어서 에러가 발생하지 않았던 모양이다. 이 라인을 수정한 뒤 다시 프로그램을 실행하였다. 그런데 또 비슷한 종류의 에러가 발생하였다. 여기 말고도 줄바꿈 실수가 있었던 곳에 다섯 군데나 더 있었던 것이다. 분명히 Perl 스크립트를 짜서 DB 파일을 수정한 것으로 아는데 왜 중간의 몇 줄에서만 오류가 발생했는지 그 이유를 모르겠다.

DB 파일 전체를 대상으로 줄바꿈 오류를 전부 수정한 뒤 테스트 데이터셋을 투입하여 Plasmid Profiler를 돌려 보았다. 이제 제대로 된 heat map이 나오기 시작한다. 이 문제로 말미암아 약 삼일을 낭비하였다. 서열 분석에서 다루는 데이터 파일에 오류가 없는지를 가끔은 점검해 볼 필요가 있다는 단순하고도 심오한 진리를 깨달았다.

글을 끝마치기에 앞서서 Enterobacteriaceae family의 플라스미드 서열 데이터셋을 하나 소개한다. 구조화된 데이터가 아니므로 database가 아니라 dataset이라 하였다.

A curated dataset of complete Enterobacteriaceae plasmids compiled from the NCBI nucleotide database. Data in Brief 2017 PMC

학술용 data를 figshare에서 공유한다는 것이 특이해서 지난주에 내 블로그에도 글을 올렸었다(링크).

2018년 10월 16일 화요일

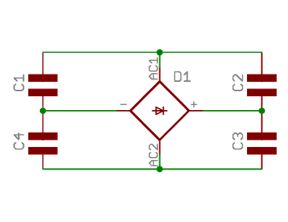
정류용 브리지 다이오드 주변에 0.01 uF 바이패스 캐패시터를 연결하는 이유

인터넷에서 프리앰프 회로를 뒤적거리다가 정류회로의 브리지 다이오드 주변에 4개의 0.01 uF 캐패시터를 연결한 것을 보게 되었다. 다음의 그림은 4S Universal Preamplifier for 12A?7 Valves에서 인용한 것이다. 이 전원회로는 Mark Houston이 작성한 것으로서 원래 Matt Renaud가 제안 간단한 프리앰프에 기초한 것이다(원본). Matt의 원본 회로에서는 정류관을 쓰고 있다.

그림 출처: diyaudioprojects.com

정류용 다이오드 주변에 소용량 캐패시터를 병렬로 배치한 것을 가끔 본 일이 있어서 그 이유가 궁금하였다. 해답은 Designing a Power Supply(Augustica Technologies)에서 찾았다.

그림 출처: Augustica Technologies.
정류용 실리콘 다이오드는 입력된 전압이 0.7 V를 넘어야 출력을 내기 시작한다. 따라서 교류가 입력되는 경우 0 V 근처에서 전혀 전류가 흐르지 않는 dead zone이 대칭적으로 생기게 된다. 유도성 소자인 트랜스포머는 이렇게 회로가 끊어진 것과 동등한 상태에서 유도 기전력을 발생한다. 트랜스포머 내부의 부유 용량(stray capacitance) 덕분에 유도 기전력이 너무 높아지지는 않지만, 이것이 발진을 일으킬 수도 있다. 0.01 uF 필름 캐패시터는 이를 바이패스시켜 제거하는 역할을 한다.

코일의 유도기전력은 전원이 차단될 때 더 심하다. 인덕터의 기초지식 가장 처음에 나오는 그림을 참고하라.