2018년 10월 21일 일요일

독서 기록 - [디스럽션] 외 세 권

대출 기간이 임박하여 책 표지 사진을 찍은 뒤 곧바로 반납을 해 버려서 간단한 서지정보만 남긴다.


디스럽션

  • "사물인터넷 비즈니스의 모든 것"
  • 저자: 강시철
커넥슈머, 프라이버시 스왑...

모든 교육은 세뇌다

  • "4차 산업혁명 시대의 경쟁력, 몰입의 힘"
  • 호리에 다카후미 저|박흥규 감수|하진수 역
도서관에는 아직도 '4차 산업혁명 관련 도서' 서가가 따로 마련되어 있다. 과연 이 유행어가 내년까지 갈지 두고 보아야 되겠다.

다시 읽는 한국 현대사

  • "정치의 새로운 실천을 기대하며"
  • 양우진 저
근대사의 전 과정을 부정의 역사로 보는 진보 진영의 시각에 대한 보수주의자의 비판. 시각을 넓혀보자는 차원에서 고른 책이다.

열한 계단

  • "나를 흔들어 깨운 불편한 지식들"
  • 채사장 저(책 소개)
이 책을 읽기 전까지는 채사장(팟캐스트 지대넓얕 진행자, 블로그)을 전혀 몰랐다. 지대넓얕이란 '지적 대화를 위한 넓고 얕은 지식'을 뜻한다. 알쓸신잡보다 먼저 만들어진 낱말인가? 인문학 = 교양이 아니다. 인문학은 그 자체로서 의미가 있는 것이지 치장을 위하여 '소비'되는 것이 아닌데.. 물론 저자의 노력을 폄훼하고자 함은 아니다. 

한자 丁에는 '고무래'라는 뜻이 전혀 없다

丁 넷째 천간 정, 장정 정

단 두 획으로 이루어진 매우 간단한 모양의 한자이다. 장정이란 한 사람의 일꾼 몫을 하는 어른 남자를 뜻한다. 군대에 갈 연령, 즉 징집 연령에 달한 남자를 뜻하는 것이기도 하다.

이 한자는 한국 또는 중국인의 성씨에도 쓰인다. 우리 집안의 성이 바로 이 한자를 쓴다. 인구 비율로 훨씬 많은 鄭(나라 정, 나라 이름 정)과 구별하기 위해 흔히 丁자를 ‘고무래 정’이라고 부르기도 한다. 고무래는 곡식 낱알 등을 긁어모으는 농기구의 일종으로 이 글자와 모양이 똑같다.

그러나 이 글자 자체에 고무래라는 뜻(訓)은 전혀 없다는 것이 나의 상식이었다. 과거에 분명히 한자사전에서 이러한 설명을 보았었다. 심지어 어떤 사람이 丁자를 ‘갈고리 정’이라고 부르는 바람에 아연실색을 한 적이 있었다. 남의 성씨를 마치 공포영화에 나올 법한 흉칙한 물건으로 칭하다니!

며칠 전에 컴퓨터를 만지작거리면서 호기심에 丁자의 의미를 검색해 보았다. 그런데 놀랍게도 ‘고무래’라는 뜻이 있는 것으로 나타나지 않는가?

먼저 네이버 한자사전. ‘고무래’라는 뜻이 맨 위에 있다.

네이버 한자사전 캡처

다음 사전. 여기에는 정확하게 풀이하였다. ‘※ 흔히 「고무래 정」이라 칭하는 것은 글자 모양에 따른 속칭임.’이라는 추가 설명이 달려 있다.

다음 사전 캡처

나무위키. 여기도 고무래를 맨 위 뜻으로 올려 놓았다.

나무위키 캡처

이외에도 한자 학습 사이트에서 丁자가 ‘고무래’를 뜻한다고 기록한 경우가 많다. 이는 잘못된 정보이다. 마치 ‘입 구(口)’자를 네모를 닮았다 하여 ‘네모 구’라 부르다가 인터넷 사전에 ‘네모’라는 뜻으로 등재하는 것과 다르지 않다.

정말 내가 알고 있는 丁의 뜻이 맞는지 확인하기 위해 직접 도서관에서 민중서림 한자대사전(전면개정·증보판)을 찾아보았다.

한자대사전 사진

그 어디에도 ‘고무래’라는 뜻은 없다. 글자의 본래 모양은 ‘못’이지 ‘고무래’가 아니다. 게다가 ‘고무래정으로 훈함은 잘못’이라고 명기되어 있다. 홍윤표 교수 또한 이 한자에 ‘고무래’ 해석이 사용된 적이 없음을 분명히 하였다(‘사나이’의 어원).

사실에 기반하지 않은 엉터리 지식이 인터넷에서 떠돌며 진짜 지식으로 둔갑하는 것이다. ‘인터넷에서 보았다’는 것은 그 지식의 정확함을 입증하지 못한다.

2018년 10월 18일 목요일

구글플러스 검색법

블로그로 작성한 글은 별도의 검색창이 있으니 찾는데 그렇게 큰 수고가 들지 않는다. 하지만 구글플러스에 내가 쓴 글을 찾는 방법을 아직도 잘 모르고 있었다. 연주회가 끝나고 기타연주자 박규희 씨와 찍은 사진을 구글플러스에서 찾느라 애를 먹은 적이 있었다.

구글을 로그아웃한 뒤 구글 검색창에 숫자로 된 내 아이디를 넣으면 내가 쓴 공개글이 다 보인다고 한다. 이외에도 몇가지 유용한 팁이 다음에 소개되어 있다.

https://plus.google.com/+googlekorea/posts/XND1ENoA3Mc

Whizz Xanadu 님이 쓴 글이다.

그런데 구글플러스 숫자 계정을 어떻게 확인해야 할까? 구글플러스 -> 프로필을 클릭하면 주소창 맨 끝에 숫자 계정이 잠깐 나왔다가 순식간에 '+영문이름'으로 바뀐다. 너무나 당연하고 간단하지만, 평소에는 일부러 찾아보지를 않으니 알 수가 없다.

또 검색을...

이렇게 짧은 글을 구글플러스가 아니라 블로그에 남기는 것은 나중에 쉽게 검색을 하기 위함이다. 아, 부끄럽다.

Plasmid Profiler 삽질기

100 건이 넘는 다제내성 Acinetobacter baumannii의 MiSeq read에 대해서는 잘 돌던 Plasmid Profiler가 40 건의 대장균 시퀀싱 결과물에 대해서는 에러를 토해내었다. 벌써 며칠째 제자리 걸음인지를 모르겠다. Plasmid Profiler를 제외하면 Galaxy를 쓰지 않으니 익숙하지 않은 시스템에서 출력하는 에러 메시지를 접해도 해결하기는 곤란할 것이라고만 짐작하였다.

파이프라인의 맨 끝까지 가서 png/html/csv 파일을 만들어내는 R 스크립트가 제대로 결과를 내지 못하는 것이 직접적인 이유였다. 이 스크립트는 사용자가 워크플로우를 실행하면서 입력하는 4 가지 파라미터 이외에 두 종류의 중간 결과 파일(BLAST TSV, SRST2 TSV)을 이용하게 된다. 에러 메시지를 직접 확인해 보았다. BLAST TSV 파일을 파싱하는데 서열 중간에 하이픈이 있다는 것이다. Plasmid Profiler가 기본적으로 제공하는 DB 파일은 플라스미드 서열 및 replicon + AMR(antimicrobial resistance) 서열 파일의 두 가지이다. 그런데 두번째 파일에서는 기본 제공된 AMR gene이 얼마 되지 않는다. 그래서 내가 ResFinder에서 항생제 내성 유전자 서열을 가져다가 기존 DB 파일 뒤에다가 추가를 한 뒤 사용을 했었다. 에러가 발생한 FASTA file의 라인 번호를 찾아가 보았다.


어라? '>'가 나오는 위치에서 줄바꿈을 하지 않은 것이었다. 이 라인은 줄을 바꾼 뒤 다음과 같이 시작하도록 고쳐야 한다.

>(AMR)mcr-1_1_KP347127

Acinetobacter baumannii의 시퀀싱 결과물을 분석할 때에는 이 AMR gene에 대한 hit가 없어서 에러가 발생하지 않았던 모양이다. 이 라인을 수정한 뒤 다시 프로그램을 실행하였다. 그런데 또 비슷한 종류의 에러가 발생하였다. 여기 말고도 줄바꿈 실수가 있었던 곳에 다섯 군데나 더 있었던 것이다. 분명히 Perl 스크립트를 짜서 DB 파일을 수정한 것으로 아는데 왜 중간의 몇 줄에서만 오류가 발생했는지 그 이유를 모르겠다.

DB 파일 전체를 대상으로 줄바꿈 오류를 전부 수정한 뒤 테스트 데이터셋을 투입하여 Plasmid Profiler를 돌려 보았다. 이제 제대로 된 heat map이 나오기 시작한다. 이 문제로 말미암아 약 삼일을 낭비하였다. 서열 분석에서 다루는 데이터 파일에 오류가 없는지를 가끔은 점검해 볼 필요가 있다는 단순하고도 심오한 진리를 깨달았다.

글을 끝마치기에 앞서서 Enterobacteriaceae family의 플라스미드 서열 데이터셋을 하나 소개한다. 구조화된 데이터가 아니므로 database가 아니라 dataset이라 하였다.

A curated dataset of complete Enterobacteriaceae plasmids compiled from the NCBI nucleotide database. Data in Brief 2017 PMC

학술용 data를 figshare에서 공유한다는 것이 특이해서 지난주에 내 블로그에도 글을 올렸었다(링크).

2018년 10월 16일 화요일

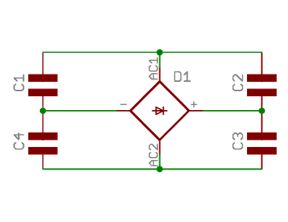
정류용 브리지 다이오드 주변에 0.01 uF 바이패스 캐패시터를 연결하는 이유

인터넷에서 프리앰프 회로를 뒤적거리다가 정류회로의 브리지 다이오드 주변에 4개의 0.01 uF 캐패시터를 연결한 것을 보게 되었다. 다음의 그림은 4S Universal Preamplifier for 12A?7 Valves에서 인용한 것이다. 이 전원회로는 Mark Houston이 작성한 것으로서 원래 Matt Renaud가 제안 간단한 프리앰프에 기초한 것이다(원본). Matt의 원본 회로에서는 정류관을 쓰고 있다.

그림 출처: diyaudioprojects.com

정류용 다이오드 주변에 소용량 캐패시터를 병렬로 배치한 것을 가끔 본 일이 있어서 그 이유가 궁금하였다. 해답은 Designing a Power Supply(Augustica Technologies)에서 찾았다.

그림 출처: Augustica Technologies.
정류용 실리콘 다이오드는 입력된 전압이 0.7 V를 넘어야 출력을 내기 시작한다. 따라서 교류가 입력되는 경우 0 V 근처에서 전혀 전류가 흐르지 않는 dead zone이 대칭적으로 생기게 된다. 유도성 소자인 트랜스포머는 이렇게 회로가 끊어진 것과 동등한 상태에서 유도 기전력을 발생한다. 트랜스포머 내부의 부유 용량(stray capacitance) 덕분에 유도 기전력이 너무 높아지지는 않지만, 이것이 발진을 일으킬 수도 있다. 0.01 uF 필름 캐패시터는 이를 바이패스시켜 제거하는 역할을 한다.

코일의 유도기전력은 전원이 차단될 때 더 심하다. 인덕터의 기초지식 가장 처음에 나오는 그림을 참고하라.

2018년 10월 12일 금요일

figshare에 데이터 파일을 올리고 공유하기

Elsevier의 학술지 Data in Brief에 소개된 어떤 유전체 서열 데이터셋의 파일을 받기 위해 URL을 확인하니 figshare였다. figshare는 (파워포인트) 문서 파일 정도를 올려서 공유하는 사이트가 아니었던가? 아, 그건 slideshare였던가? 그런지도 모르겠다.

웹사이트를 방문하니 Store, share, discover research라는 문구가 보였다. Elsevier와 협정을 맺고서 이 저널에 출판되는 논문에 부속되는 대용량 데이터에 한해서 업로드 및 공유가 가능한 것인지, 혹은 이 저널과 관계없이 누구나 회원 등록을 하면 데이터를 올릴 수 있는 것인지는 잘 모르겠다. 데이터 등록 요령 사이트를 방문해 보았다.

How to upload and publish my data

개인 공간에는 20 GB를, 공개하는 경우에는 용량에 제한이 없다고 한다. 한번에 올릴 수 있는 파일의 크기는 5 GB이다. 그러면 어떻게 수익을 창출하는지 매우 궁금하다. 혹시 이것 역시 공공 기관에서의 접속이 막혀있는 것은 아닌지 모르겠다. 구글 드라이브나 드롭박스가 그랬듯이 말이다. 백문이 불여일견이다. 회원 등록을 하고 웹 인터페이스에 논문 PDF 파일을 하나 드래그하여 넣었다. 나에게 저작권이 있는 것이 이나니 'Publish' 버튼을 클릭하지는 않았다.

잘 들어간다. 채워야 하는 메타데이터는 다음과 같다.


남들도 다 아는 것을 뒤늦게 발견한 것은 아닌지 모르겠다. 공공 목적이 큰 데이터라면 여기에 올리는 것도 좋을 것 같다는 생각이 들었다. 학술 목적이 아닌 것이면 또 어떠랴.

Publish or perish가 아니고 이제는 Share or perish의 시대가 되었는지도 모르겠다. 약간 냉소적으로 말한다면 공개는 곧 미덕이므로 '사생활도 없다'.

Awk를 이용한 간단한 텍스트 파일 조작(join)

Awk는 개발자 세 사람 - Alfred Aho, Peter Weinberger 및 Brian Kerninghan - 이름의 머리글자를 따서 명명된 프로그래밍 언어이다. 이들은 전부 1940년대 초반에 출생하신 원로이다. 아마추어 무선을 하는 사람을 일컫는 ham (ham radio)역시 무선통신의 역사를 세운 세 사람의 이름인 Hertz, Armstrong, Marconi에서 왔다는 설도 있으나 이는 근거가 없다고 한다(Etymology of ham radio). 여담이지만 우리나라에서는 radio라 하면 공중파 방송을 듣는 라디오 수신기만을 생각하지만, 미국에서는 무선을 이용한 모든 활동을 뜻하는 것 같다. 무전기(휴대용 및 거치형 전부)를 two-way radio라고도 부른다고 하니 말이다.

우선 첫번째 AWK 사례를 설명해 보자. 왼쪽과 같이 의 조합으로 이루어진 단순한 텍스트 파일이 있다고 가정한다. 이를 오른쪽처럼 변환하려면 어떻게 하면 좋을까?


이때 awk의 associative array(예제 링크)가 쓰이게 된다. Associative array는 숫자가 아닌 것도 인덱스로 사용할 수 있는 배열을 의미한다. Perl에서 흔히 사용하는 hash와 매우 유사하다. 위에서 기술한 매우 간단한 과업을 수행하려면 다음의 명령어 한 줄이면 된다.
$ awk -F, '{a[$1] = a[$1] FS $2} END{for (i in a) print i a[i]}' file
-F,는 입력 파일의 field separator를 쉼표로 지정한다는 뜻이다. {}으로 둘러싼 AWK 명령어 내부에서는 FS가 같은 의미로 쓰였다.

다음으로는 두 텍스트 파일을 공통된 컬럼 값으로 묶는 약간 복잡한 응용 사례이다. Using Awk to join two files based on several columns를 참조하였다. 여러 컬럼으로 이루어진 두 개의 텍스트 파일 file_a.bed와 file_b.bed가 있다고 가정하자. 첫번째 파일의 컬럼 1-2와 두번째 파일의 컬럼 3-4가 동등한 종류의 내용을 담고 있다. 빨갛게 표시한 것은 값 자체가 같은 것이다. 컬럼을 구분하는 것은 공백이 아니고 탭문자이다.

$ cat file_a.bed
chr1 123 aa b c d
chr1 234 a b c d
chr1 345 aa b c d
chr1 456 a b c d
$ cat file_b.bed 
xxxx abcd chr1 123 aa c d e
yyyy defg chr1 345 aa e f g

이때 다음과 같이 두번째 파일에서 동일한 라인에 해당되는 결과를 끌어다가 첫번째 파일의 해당되는 라인에 출력하는 것이 목적이라고 하자. 아래 그림에서는 파랑색으로 표시하였다.

chr1 123 aa b c xxxx abcd
chr1 234 a b c
chr1 345 aa b c yyyy defg
chr1 456 a b c

다음과 같이 awk 명령어를 작성하면 된다(명령어 1).

$ awk 'NR==FNR{a[$3,$4,$5]=$1OFS$2;next}{$6=a[$1,$2,$3];print}' OFS='\t' file_b.bed file_a.bed

읽어 들인 라인에 대해서 associative array가 어떻게 작동하는지는 이 글의 뒷부분에 [Awk associative array의 활용 예제]를 통해서 설명하였다. 먼저 awk의 내장 변수에 대해서 이해를 넓힐 필요가 있다. NR는 현재 처리 중인 라인 번호를 의미한다. Awk가 여러 파일을 처리하는 경우 NR은 전체 파일에 대한 라인 번호를, FNR은 각 입력 파일에 대한 라인 번호를 의미한다. 다음을 실행해보면 감이 잡힐 것이다. 인수로 주어진 파일은 두 개이지만, awk는 라인 단위로 순차적인 처리를 하게 되므로 첫 번째 파일(file_a.bed)에 대해서 작업을 먼저 한 뒤, 이어서 두 번째 파일(file_b.bed)를 가지고서 일을 하게 된다.

$ awk '{print FILENAME, NR, FNR}' file_a.bed file_b.bed
file_a.bed 1 1
file_a.bed 2 2
file_a.bed 3 3
file_a.bed 4 4
file_b.bed 5 1
file_b.bed 6 2

명령어 1을 실행할 때 언제 NR==FNR{}의 조건을 충족하게 되는가? 첫 번째 파일에 대한 작업을 할 때이다. 즉, 첫번째 인수로 주어진 파일(file_a.bed)에 대해서 {} 내의 명령을 실행하라는 뜻이다. next는 그 다음에 따라오는 {} 명령어 블록을 실행하지 말라는 뜻이다. 이것은 대단히 중요하지만 약간 어려운 개념이다. 그림으로 설명을 해 보겠다. 부디 내가 이해한 것이 옳기를 바란다. 별도로 작성한 글 awk와 sed를 사용하여 multi-fasta 파일의 서열 ID를 일괄적으로 바꾸기에서도 next문의 중요성을 설명하였다.

numbers라는 파일은 각 라인에 1..10까지의 숫자를 수록하고 있다. 각 라인의 수와 홀수 또는 짝수줄 여부를 화면으로 프린트하려면 어떻게 하는지를 다음의 그림에 설명하였다. next가 왜 중요한지를 잘 보여준다.


그러면 다시 원래의 awk 문으로 돌아가자. 두번째 인수로 주어진 file_a.bed에 대해서는 NR==FNR이 FALSE가 된다. 따라서 두번째 {} 내부의 명령어를 수행하게 된다. 즉 file_a.bed를 읽어서 마지막 필드($6)를 associative array의 값으로 바꾸어서 프린트하게 된다.

어쩌면 if..else를 쓰는 것이 좀 더 명확할지도 모르겠다.

$ awk '{if(NR==FNR){a[$3,$4,$5]=$1OFS$2}else{$6=a[$1,$2,$3];print}}' OFS='\t' file_b.bed file_a.bed

첫번째 주어진 답을 다르게 표현하면 이렇게 된다. 오히려 이것도 이해하기 쉬운 해결책이다.

$ awk 'NR==FNR{a[$3,$4,$5]=$1OFS$2}NR!=FNR{$6=a[$1,$2,$3];print}' OFS='\t' file_b.bed file_a.bed

awk에서 다음을 잘 구별하는 노력이 필요하다.
  • 조건{...} {...} <= 조심해서 써야 한다!
  • 조건{...;next}{...} <= 이 사례는 의외로 유용하다. 어떤 조건을 만족하는 라인은 조작을 가해서 출력하고, 조건을 충족시키지 않는 것을 그대로 출력하는데 좋다. FASTA file의 서열 ID만 바꾸는 경우가 이에 해당한다. sed로도 이렇게 할 수 있을까>?
  • 조건1{...} 조건2{...}
  • if문을 사용하는 것

[업데이트] Awk associative array의 활용 예제

이 글을 추가로 써 넣으면서 걱정이 앞서기 시작하였다. awk는 그렇게 고수준의 언어가 아니라서 복잡한 일을 시키기는 곤란하다. 아래에서 든 예제 및 결과를 나중에 다시 찾아보았을때 어떻게 동작하는지를 이해하지 못하게 될까봐 고민이다. 자주 읽어보고 실습을 해 보는 것이 해결책이다.

두 개의 파일(file_a, file_b)를 갖고 있다고 가정하자. 첫번째 파일 file_a는 자료를 담고 있고, 이 중에서 첫번째 컬럼에 특정 값이 있는 경우 그 라인만을 뽑아내고 싶다. 해당되는 값은 두번째 파일 file_b의 첫번째 컬럼(key)에 담겨 있다. 만약 file_b가 하나의 컬럼만으로 구성되어 있다면 shell 환경에서 grep -f file_b file_a라고 입력하면 된다. 그러나 파일이 길어지면 속도가 느려질 것이 뻔하고(file_b에 수록된 패턴 한 줄에 대해서 file_a 전체를 훑는 일을 계속 반복해야 하므로), file_a의 해당되는 라인을 출력하는 것 이외의 일은 하지 못할 것이다.

$ cat file_a
1 A
2 B
3 C
4 D
5 E
6 F
7 G
8 H
9 I
10 J
$ cat file_b
7 seven
3 three
6 six
2 two

첫번째 파일을 그대로 출력하되 두번째 파일에서 정의된 라인 뒤에 특별한 표시를 하는 것이 작업 목표이다. 표시할 값은 두번째 파일의 두번째 컬럼(value)에서 나열한 값이다. 실생활에서 쉽게 접할 수 있는 사례를 들자면 한 파일에는 학번과 과목별 점수가, 다른 파일에는 학번과 이름이 적혀 있는 상황에서 학번, 이름, 점수를 표시하는 일과 같은 것을 생각하면 된다. 두 파일에서 동일한 성격의 값이 수록된 필드, 즉 첫번째 컬럼이 동일한지를 살피는 것이 핵심이다. 만약 두번째 파일에 엉뚱하게 '0 zero'가 있다면 어떻게 할 것인가? 이것까지는 해결하지 못한다.

$ awk -F '\t' 'NR==FNR{a[$1]=$2;next}{$3=a[$1];print}' OFS='\t' file_b file_a
1 A 
2 B two
3 C three
4 D 
5 E 
6 F six
7 G seven
8 H 
9 I 
10 J 

아니면 지정된 라인만 출력하고 싶다. 이건 조금 더 까다롭다. 왜냐하면 if(..){..} 구문이 들어가야 하기 때문이다.


$ awk -F '\t' 'NR==FNR{a[$1]=$1;next}{if($1==a[$1]){print}}' OFS='\t' file_b file_a
2 B
3 C
6 F
7 G

지정된 라인만 출력하되 약간의 장식을 하려면 두번째의 array가 필요해진다. b[$1]=1이라 선언하고 뒤의 if문에서 b[$1]==1로 하는 것이 좀 더 간단하다. Perl이라면 hash를 이용하면 되고, if exists $seen{$key} 구문을 이용하여 주어진 key를 갖는 hash가 존재하는지를 점검할 수 있다. 그러나 awk에서는 그렇게까지 하지 못하기 때문에 두번째의 associative array인 b[]를 도입하게 된 것이다.

$ awk -F '\t' 'NR==FNR{a[$1]=$2;b[$1]=$1;next}{if(b[$1]==$1){$3="FOUND!";print}}' OFS='\t' file_b file_a
2 B FOUND!
3 C FOUND!
6 F FOUND!
7 G FOUND!

$ awk -F '\t' 'NR==FNR{a[$1]=$2;b[$1]=$1;next}{if(b[$1]==$1){$3=a[$1];print}}' OFS='\t' file_b file_a
2 B two
3 C three
6 F six
7 G seven

위의 사례에서는 file_a에서 원하는 라인을 그대로 출력해 놓고 라인의 끝에 추가적인 컬럼을 덧붙이는 형식이었다. 군더더기 없이 file_a를 그대로 출력하되 숫자 자리(첫번째 컬럼)를 아예 치환하고 싶다면?

$ awk -F '\t' 'NR==FNR{a[$1]=$2;b[$1]=$1;next}{if(b[$1]==$1){$1=a[$1];print}}' OFS='\t' file_b file_a
two B
three C
six F
seven G

위 예문을 기초로 하여 여러 가지 응용과 변형을 가해 보는 것이 좋을 것이다.